А Мерлоу, Пякина в очко драл.
Мнение?🧐
Ка́мни И́ки — коллекция валунов, камней из андезита, окатанных речной водой, на поверхности которых выгравированы древние обитатели Анд в сюжетах, противоречaщих современной хронологии[1][2]. В настоящее время известно более 50 тысяч таких камней[3].
Коллекция камней была собрана в окрестностях перуанского города Ика (в котором сейчас и хранится большая их часть), в связи с которым она и получила своё название[4]. Размеры и масса камней разные: маленькие весят по 15—20 граммов, а самые большие достигают полутонны при высоте в 1,5 метра. Наиболее распространённый размер соответствует арбузу. Цвет камней преимущественно чёрный, но встречаются серые, бежевые и розоватые[3].
Коллекция камней была собрана в окрестностях перуанского города Ика (в котором сейчас и хранится большая их часть), в связи с которым она и получила своё название[4]. Размеры и масса камней разные: маленькие весят по 15—20 граммов, а самые большие достигают полутонны при высоте в 1,5 метра. Наиболее распространённый размер соответствует арбузу. Цвет камней преимущественно чёрный, но встречаются серые, бежевые и розоватые[3].
Это новодел. Индейцы балуются для туристов.
А делали анализ бумаги (или пергамента?) на возраст? Интересно когда эту хуйню нарисовали?
Сказано же: в Средневековье.
новодел это Кремль и китайская стена, сскорее всего созданы после второй мировой
Что нету фоток 19 века этих построе?

Почему этот текст не засунули еще в нейронку типа Клауда и не расщшифровали?
Нихуя. Мне бабка рассказывала, что он – Кремль в 30-е до WW2 был, когда она будучи малой девчонкой со своим батей – моим прадедом – там гуляли по Красной площади.
Прадед ей ещё тогда говорил, что пидораса членина вместе с мавзолеем уберут когда-нибудь нахер оттуда.
90 лет прошло, пока не убрали.
Итак, после объемного и широкого вступления обратимся к сути статьи. В 2016 году Энигму от мира литературы попытались взломать с помощью нейросети. Да, именно в 2016 — СМИ узнали об этих попытках только в 2018, из-за этого даты часто путают. Вот ссылка на оригинальное исследование. Текст на английском, поэтому нужно хотя бы немного разбираться в научной терминологии.
Канадские ученые «натренировали» нейросеть на распознание отдельных элементов алфавита и лексем из 380 существующих или ранее существовавших мировых языков. Как утверждали исследователи, точность анализа нейросети была в пределах 97%.
Система показала, что наиболее вероятный язык рукописи — иврит. Конечно, не простой иврит, а с подвыподвертом. Исследователи предположили, что в книге есть довольно простой шифр, при котором знаки огласовок опускаются или шифруются с помощью других символов, а согласные размещаются в алфавитном или произвольном порядке.
Стоит также уточнить, что система давала также и другие возможные исходники: мазатек (язык аборигенов современного юга Мексики), мозарабский (арабизированный язык Пиренейского полуострова), итальянский и язык ладино (язык евреев Пиренейского полуострова). Также нейросеть нашла элементы стандартного арабского и амхарского языка (территория современной Эфиопии, входит в семитскую группу).
Такой подход вдруг дал результат и нейросеть смогла перевести часть текста книги. Первая фраза была переведена как:
She made recommendations to the priest, man of the house and me and people.
Она дала советы священнику, хозяину дома, мне и людям.
Казалось бы, вот он, триумф искусственного интеллекта! На базе такой трактовки и иллюстраций исследователи даже сделали предположение, что рукопись Войнича была своеобразной фармакопеей — медицинской книгой, в которой описывалось целебное значение трав, способы изготовления и применения лекарственных препаратов, а также строение человеческого тела.
Всего алгоритм «опознал» примерно 80% слов из всей рукописи. За основу анализа было взято то же самое предположение об отсутствии огласовок и произвольном порядке букв в словах.
Но вот повторные проверки первой тестовой фразы показали другой результат:
And the priest made a man for him to his house, and to his men.
И священник сделал человека для него и для его дома, и его людей.
Unleavened bread and made her the priest, and one which leaves his home.
Пресный хлеб и сделал ее священником, и той, кто покидает его дом.
Во фразах меньше смысла, чем в первоначальном варианте, но в теории это можно списать на несовершенство переводческих алгоритмов системы. В целом же лексические основы во всех вариантах перевода остались неизменными: «священник» и «дом».
Можно было бы заявлять об успехе, но есть парочка серьезных «но», которые не делают результаты исследования сенсационными.
Во-первых, настройки нейросети позволяли некую вольность в трактовке слов, ведь даже если учесть, что алфавит — это просто измененное начертание букв иврита, то существует довольно много вариантов слов, которые можно составить при перестановке букв.
Если же предположить, что язык рукописи не иврит, а просто принадлежащий к семитской группе или же родственный с ней, то совершённый анализ не будет иметь смысла — становится слишком много вариантов для анализа даже тех символов, значение которых вроде как уже определили. А неизвестных — еще больше.
В этой ситуации хочется вспомнить теорему о бесконечных обезьянах. Если кто не слышал, вот она:
Допустим, что у нас есть бесконечное число обезьян с печатными машинками, каждая из которых произвольным образом стучит по клавишам неограниченного количества времени.
Рано или поздно одна из обезьян сможет «настучать» любой произвольно заданный текст: будь то короткая записка или «Война и мир».
Эту теорию можно применить в случае интерпретации текста нейросетью. Изначально сама нейросеть создает пул вариантов значения каждого из слова, а затем из всего пула вариантов выбирает наиболее возможные интерпретации, исходя из комбинаций с соседними вариантами.
В результате в предложении из 5-8 предполагаемых слов получаем несколько десятков тысяч вариантов, из которых нейросеть выбирает один, который несет больше всего смысла.
То есть, есть очень большая вероятность, что среди этих разрозненных вариантов случайно найдется один или несколько, которые реально будут иметь смысл. При этом если здесь есть более сложный шифр или иная лексическая структура предложений или слов, то способ оказывается ложно положительным.
По факту какой-то результат есть, его можно «пощупать» и представить публике, но толку от него нет никакого, потому что он ни на шаг не приближает к реальной разгадке шифра.
Да и объективно соединить начертание букв алфавита с ивритом — решение довольно необычное. Тем не менее, большинство исследователей рукописи сомневаются, что исходный язык рукописи — иврит. Лексическая структура довольно сильно не совпадает, а разобрать степень шифрования, если она есть, все еще не представляется возможным.
Более того, некоторые считают, что лингвисты с нейросетью проводили не объективный анализ, а искали подтверждение отдельной теории. Гипотезу о том, что книга является фармакопеей, можно сделать, исходя из рисунков трав, людей и звездных тел, даже без анализа текста.
В итоге результаты исследований не приняли в научном обществе. Потому что они не раскрывают конкретных особенностей и принципов языка, как требуется для полноценного лингвистического исследования наречий. Для того, чтобы результаты исследований признали, банально не хватает доказательной базы. Невозможно проследить четкую логическую цепочку, которой руководствовалась нейронная сеть во время анализа, поэтому результаты нельзя считать научно обоснованными — есть ненулевой шанс, что цепочка окажется ошибочной.
Впрочем, адекватных гипотез насчет манускрипта Войнича больше не было.
Лингвисты предпринимали попытки, но все они больше похожи на фарс. К примеру, в 2019 году один британский ученый заявил, что он разгадал код Войнича. Но теория о «протороманском языке» или вульгарной латыни была резко раскритикована учеными, которые обвинили британца в том, что он искусственно подбирал слова без определения принципов письма и без убедительных доводов о лексических связях между смыслами.
Сейчас уже 2020 и шумиха вокруг «единственной и правильной расшифровки рукописи Войнича» утихла. Он все так же продолжает считаться одной из главных лингвистических и криптологических загадок современности.
Хочется, конечно, верить в то, что когда-нибудь его все-таки разгадают. Если это какая-нибудь разновидность языка, то вполне возможно. Но если это все же шифр с утраченным ключом, то рукопись рискует навсегда остаться просто красивой древней книгой с таинственной историей.
Вообще лингвистические загадки — это очень крутая тема. Кроссворды и филворды — это только верхушка айсберга — есть очень много способов одновременно учить английский и прокачивать логику и мышление. Преподаватели EnglishDom часто используют их на занятиях, чтобы разнообразить процесс обучения и сделать его более интересным.
>В 2016 году
Бля ну с тех пор нейронки шагнули далеко вперед, очевидно, что ссатся узнать правду о мироздании из рукописи. Есть у кого платный аккич с Клаудом? Закиньте туда скрины рукописи и выложите сюда результат...
Уже пытались, и не раз, с ожидаемым результатом нейронка галлюционировала, что это или иврит,или неизвестный прото-язык романской группы, или что-нибудь ещё). Я думаю, если его и расшифруют, то это уже сделает полноценный AGI способный на креативное мышление и построение запредельных логических связей.
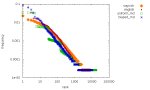
Единственный настоящий прорыв, который я помню из последних лет - это то, что рукопись статистически подчиняется закону Ципфа, т.е. это не средневековый наёб лохов рандомными символами, а там реально скрыт какой-то человеческий язык.
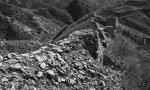
И Кремль и китайскую стену восстанавливали и перестраивали в 20-м веке. Ибо например Кремлевскую стену в 1812 года На поле он подорвал ее, а во время боев с юнкерами его здорово покоцали красные артиллерией. А у китаез китайская стена до реконструкции выглядела буквально пикрил, и это еще хорошо сохранившийся участок.


Рукопись Войнича (Voynich manuscript) — это загадочная книга неясного содержания, состоящая из 240 страниц, с иллюстрациями, автор которой неизвестен. Алфавит и язык, использованные в книге, никто не может расшифровать, они не имеют ничего общего с современными языками; по-видимому, она служила справочником для алхимиков Средневековья. Своё название рукопись получила по имени Уилфрида Войнича, американца польского происхождения, антиквара, который приобрёл её в Италии в 1912 году. В 2005 году рукопись была передана в Библиотеку редких книг и рукописей Бейнеке Йельский университет , где она получила инвентарный номер MS 408.