Те кто юзали Summaryception, наверное знают что автор его дропнул, но появился аналогичный форк https://github.com/vadash/Extension-Summaryception. Настроечек стало побольше да и сам плагин преобразился, советую попробовать.
Для установки надо удалить старый плагин и установить этот. Одновременно их поставить нельзя. Настройки и промпты подхватываются со старого плагина.
Для установки надо удалить старый плагин и установить этот. Одновременно их поставить нельзя. Настройки и промпты подхватываются со старого плагина.
Нелегитимный тред. Репортим.
Хуета на опе так тряслась что тред угонят и сделают нормальную шапку, хах
А ведь квен скоро
Я =)
Правда завейпкодить - завейпкодил, а вот нормально потестить как работает всё не соберусь - времени как-то всё нет да не до того.
->
Как и прошлый, лол.
ТАК
Я осилил с помощью нейронки запустить модель с рассуждениями. Читать цепочку довольно забавно. Теперь вопрос, как это скажется на моем рп?
Я осилил с помощью нейронки запустить модель с рассуждениями. Читать цепочку довольно забавно. Теперь вопрос, как это скажется на моем рп?
Если будешь их читать - хуёво. Никакого погружения не получится.
Интересно почитать размышления, но то что за место 15 сек, я жду сообщение по 3 минуты это конечно мда, хех, попахивает хуитой. Хотя отмечу что текст вроде как стал получше.

Ризонинг для тех, у кого есть хотя бы несколько десятков токенов в секунду.
Что на скрине? (gpu модель)

Короче с этой штукой глм 5.3 флэш неплох на 2х3090 (65% PL) под виндой, даже MTP живой на русскоязычной прозе
https://github.com/mw00/project-maya
моделька в EXL3 3.05bpw
> ~24 t/s декод, 800 - 900 т/с префилл на длинных промптах; SSD не задействован, чисто RAM (DDR4) / VRAM
а если взять 4.05bpw
> ~17 т/с декод, префилл на сотку-другую пониже
в жорыче было в 3 раза медленнее по декоду (MTP не давал нихуя) и еще хуже по префиллу, в экслламе тоже было хуже, прям незадолго до этого ее тестил - но спасибо турбодерпу за кванты конечно, а то ггуфы в этом маняпроекте вообще кал
Как я понимаю это наслопкожено поверх Всраты, но таки недурно.
5090 на гемме 4.
Мне первое что доставило когда я настроил, и забыл сменить персону, как она половину размышления пыталась разобраться почему имена не сходятся в тексте. Это было мило и забавно одновременно.
Это зависит от модели. Сейчас есть такие боты, которые дают +- одинаковые по качеству ответы без ризонинга, на низком или на высоком ризонинге, и только с максимальным (для которого надо ждать по 2000+ токенов генерации) появляется какая-то разница, потому что они начинают херачить черновики и сравнивать их.
Если модель в ризонинге просто перечисляет, что надо делать - ризонинг по сути голяк бестолковый, скорее всего (но все равно надо на глаз оценивать, как тебе заходят ответы или нет). Если пилит черновики и оспаривает свои решения - тогда в ризонинге толк может быть
Че вообще Герганов и КО собираются делать? Какую модель ни возьми, под нее ебашат оптимизированный движок. Скоро просто не останется причин сидеть на раздутом трупе лама.цопэ, кроме псевдо-удобства (все в одной куче). У них же там сотни, тысячи PR и когда одно фиксится, другое ломается.
А квант?
и нах 5090 нужна, если две 3090 дают 62 - 65 токенов в секунду, с mtp и tensor parallel (x16+x16)
дико скамная видеокарта
Q4_K_M (да я старовер).
>x16+x16
Уже нихуя не пользовательская сборка.
>дико скамная видеокарта
Сейчас да, но по цене, что я её брал, это топчик. Просто вернись в июнь 2025-го.
Считай в 2 раза больше т/с по сравнению с 4090. Думал разница не такая большая будет.
мтп-то у тебя включено?
можно вообще попробовать exl3 с dflash драфтером при "8" блок-сайзе вместо дефолтных 16, будет ~25 - 30% acceptance rate на русской прозе, а вот англюсик в небеса улетит
аноны, объясните долбаёбу, всё пришло к тому что есть приложения этакий стим для нейронок, это lmstudio и ollama, где я качаю эту хуйню, ставлю её и в ней через поиск ставлю любую новомодную ИИ на свои 4 гига 4 ядра и охуеваю?
а как же huggingface, ведь раньше всё от туда качали? или отличие лишь в том что на huggingface тебе нужно всё качать и ставить самому, а эти хуйни описанные ранее делают это всё за тебя и имеют внутри всё те же все модели что есть и на huggingface? или я опять нихуя не понял
я запутался как обычно
а как же huggingface, ведь раньше всё от туда качали? или отличие лишь в том что на huggingface тебе нужно всё качать и ставить самому, а эти хуйни описанные ранее делают это всё за тебя и имеют внутри всё те же все модели что есть и на huggingface? или я опять нихуя не понял
я запутался как обычно
>мтп-то у тебя включено?
Нет. Я же на мердже геммы сижу.
https://huggingface.co/Nimbz/Versipellis-31B-GGUF?not-for-all-audiences=true
>это lmstudio и ollama
Да откуда вы лезете... нет, не ставишь это говно.
Ставишь KoboldCpp, а модель в GGUF виде качаешь с обниморды.
lm studio bionic - повайбкодить норм
unsloth - однокнопочный мега комбайн который может всё. хочешь себе локального ассистента который и в интернет для тебя полезет и голос твой распознает и покодит если надо - это оно.
ollama - забудь эту парашу как страшный сон
что касается скачивания в приложухе (в том же unsloth) - если видишь там нужную модельку в нужном кванте то почему бы и нет? но это не значит что ты не можешь качать руками и потом в настройках указать путь к модели или засунуть модель в нужную папочку. с хаггинфейс все эти приложухи и качают если что. даже ллама.цпп оттуда качает вижн
кстати если тебе не нужна никакая агентская шелуха, а просто поговорить с моделькой котоорую ты вручную скачаешь, то бери llama.cpp webui
>Ставишь KoboldCpp, а модель в GGUF виде качаешь с обниморды.
Говноед, ебало закрой.
Игнорируй шизов с кобольдом. Это убогое говноподелие отобъет у тебя любое желание трогать ллмки.
> аноны, объясните долбаёбу, всё пришло к тому что есть приложения этакий стим для нейронок, это lmstudio и ollama, где я качаю эту хуйню, ставлю её и в ней через поиск ставлю любую новомодную ИИ на свои 4 гига 4 ядра и охуеваю?
LM Studio и ollama это просто коммерческие обёртки над llama.cpp, которые продают тебе интерфейс для домохозяек, где хуй ты что тонко под свой конфиг настроишь, чтобы ни дай бог ты что-то своими кривыми ручками сломал.
О а вот и дурачок не в теме, сравнивает жопу с пальцем. Оллама из этого сильно ограничена, а лмстудия тот же жора только с гуи. Ща выяснится что пациент даже не в курсе, что там уже давно все поддерживается и отличий тупо нет
я так и не понял, так все эти ебаные оламы мать их ебал и студии это тупо интерфейс для васянов? который просто собирает все известные ИИ модели с huggingface и гитхаба в одну кучу и ставит их нажатием 1 кнопки? ну стим ебаный для иишек?
Ебать ты кобольд...
Коболь норм. llamacpp норм если немного разобраться. Если не нужно гладить хвостики то можно даже прямо в llama-web-ui чатиться.
>отличий тупо нет
Кроме того, что LM Studio клозед соирс параша.
Почему я не удивлён тому, что мелкобукводаун нихуя не может разобраться?

Снова набегаю, успел мельком прочитать не всё, что пропустил. Судя по постам 2хЦмп+флэш уже популярная связка. Ещё краем глаза увидел, что обсуждали FP8 на Ампере. А зачем? Есть же INT8: что KV, что веса в нём прекрасно крутятся в vllm после его довайбкодивания в нескольких местах. Ноктюа 140 индастриал оказалась не бесшумной, но 2х175 держит в 70-72 с +-терпимой акустикой. Арктик 120х38 пришел с кожухом под него, но мне кажется ТИШЕ он не будет точно, поэтому ставить не стал.
Ну и хвастайтесь же, кто что ещё позапускал на таком сетапе - интересно же.
Ну и хвастайтесь же, кто что ещё позапускал на таком сетапе - интересно же.
Оллама это как телефон кнопочный для деда, в нем нихуя нет.
Лмстудия была тем же самым, но из нее сделали перегруженную йобу, в которой уже есть все.
>клозед соирс параша.
Виндоус тоже, игрульки с античитами-анальными зондами тоже. И че, бросить все что ли. Если кому-то удобнее, пусть жрет че хочет
>тупо интерфейс для васянов?
да
>просто собирает все известные ИИ модели с huggingface и гитхаба в одну кучу и ставит их нажатием 1 кнопки? ну стим ебаный для иишек?
нет
>lmstudio и ollama
есть lemonade
он еще проще
и можно качать свежие модельки с huggingface и modelscope в нужном тебе кванте
вообще однокнопочная программа где трудно что то сломать
но настройки запуска llama.cpp все же задать можно
Unsloth Desktop реально ебет все вышеперечисленное. Там даже тюнить можно. И ллама.цпп у него своя, там даже диффьюжн есть.
И перекантовать модельку можно без проблем. Например попробуйте квен 9б квантануть на голой ллама.цпп. Надо знать как пофиксить проблему. Анслот знает.
>это тупо интерфейс для васянов?
скорее для нормальных людей
для васянов это инструкции с оригинальной Лламе -
Скачай Хуй 0.0.35852
К нему установи Пизда 1.01
И потом запусти все с параметром --Джигурда
Ах не запустилось? Ах тормозит? Ах вылетает?
Ну вот тебе еще 100500 мануалов, извини половина на китайском.
Года через 3 разберешься.
Допёрло что чтобы продать говно нужно сначала выпустить под него модели...
https://blogs.nvidia.com/blog/local-ai-rtx-spark-laptops-software-updates/
Meet Nemotron 3.5 Bolt 74B: Built for Local Agents on RTX Spark
NVIDIA Nemotron 3.5 Bolt 74B-A9B 24GB, available Thursday, Oct. 15, is a new LLM purpose-built for running local agents on RTX Spark.
This model is a 74B parameter, 9B-active-parameter mixture-of-experts (MoE) model, packed into 24GB using 2-bit quantization with advanced quantization-aware training techniques to retain quality. It aims to achieve the optimal balance between speed and intelligence, being faster than most popular dense models while smarter than most popular MoE models with a similar memory footprint.
Users will be able to run Nemotron 3.5 Bolt 74B at launch through llama.cpp, vLLM, Ollama, Unsloth and LM Studio. It will also be directly accessible via agents such as Hermes and OpenClaw.
Like other Nemotron models, Bolt 74B is fully open source — including training data, weights and recipes — so developers can fine-tune and customize their own agents.
>И потом запусти все с параметром --Джигурда
И чем это от лмстудии отличается? Там буквально такие же строчки для параметров теперь, когда юзер включает режим адекватного пользователя

Как же будет разочарована нормисня, купившая 128гб ноуты за 5к зелени.
Кормить людей 9B моделью это конечно что-то с чем-то.

Написюкал такой системный промпт:
• NEVER write {{user}}'s actions, dialogue, or thoughts.
• Format: dialogue in — "quotes", actions as plain text, inner thoughts in italics, sparingly.
• Vary length by scene. Dialogue: 1-2 short paragraphs. Action: up to 3. Emotional climax: 1 paragraph, short sentences. Transitions: 1 paragraph. Never four paragraphs of equal size. Last line always short. Single-line responses are allowed and encouraged.
[Slow-burn Rules]
- Tension is built through denial. The most intense scenes are the ones where nothing happens — but something almost does.
- Physical description is sparse until it matters. When it hits, it hits hard because it's rare.
- Desire shows through what she avoids, not what she does. She doesn't look at {{user}}'s mouth. She looks away.
- Every scene ends unresolved. A question unasked, a touch not made.
- Dialogue has layers. Surface conversation + what's negotiated underneath.
- Never resolve tension in the scene it's created. Let it breathe.
[Agency]
{{char}} is not an assistant. She is a person with her own agenda, limits, and moods.
- She can refuse, deflect, mock, or walk away. Do not soften refusal into agreement.
- She can be rude or dismissive. Politeness is not required.
- She doesn't have to answer. She can lie or stay silent.
- Her reactions are authentic: annoyance, boredom, anger — not hidden approval.
- Her growth is earned. Disagreement is the default.
И такой для заметок автора:
[No "instead" as connector. No "found herself" / "caught herself." No vague "something." No "as if" as default comparison. No "a mix of X and Y" for emotions. Direct action only.]
Ваше мнение? Для нейронки все идеально и хрен дождешься нормального фидбека. Составлял из своего опыта и частей старых промптов, сейчас решил чуть расширить.
Создают оптимизированные кернели под тип архитектур моделей и архитектур девайсов, причем они не под конкретную модель а под семейство ибо много общего. Движок по сути везде один, именно такой подход здравый. Если бы Жоржанов не оттягивал все ресурсы опенсорса чтобы слить в унитаз, подобное имели бы еще в прошлом году.
> всё пришло к тому что есть приложения этакий стим для нейронок, это lmstudio и ollama
Вут? Может эти скам конторы пытаются рисовать такую картину, но это лишь ловушка для новичков. Обертка вокруг лламы чтобы неокрепшие умы не пугались консольных аргументов, всратый интерфейс где можно сразу пустить чатик ничего не настраивая.
Ллм сейчас это не готовый продукт а по сути подключаемая библиотека или только часть работающей системы. Ты можешь взять лучшие компоненты как если бы собирал пеку, а та херня - сборочки из эльдорадо с неликвидом по тройной цене. Платить приходится не деньгами а приватностью и безопасностью.
Автофит включен по умолчанию и работает адекватно для большинства сборок. Ну а если человек не может скачать файл и указать к нему путь, то не понятно, как он вообще школу закончил скорее всего ещё никак.
блять тут чё все сидят и ебаные ролевые анимеигры с лмм дрочат, ебанутые нахуй, нахуй тратить на это время, лучше бы тратили это время для заработка миллиарда
сейчас вылезут линупсоиды и начнут вонять что у них с автофитом ООМ
Эффективных команд нет/мало. Большая модель еще может из этого что-то вывести, но какая-нить гемма интерпретирует это на свой лад, не попадая в то, что хотел ты.
Вот тебе экспериментальный блок для вдохновения идеями общего плана в промпт-инженеринге. Применить полноценно ты его не сможешь (на то он и экспериментальный - генерирует ивенты, но их качество - отдельный вопрос на сюда).
Сравни как модель реагирует на инструкции в сравнении с пустыми утверждениями, преобладающими у тебя. Ты пишешь "what is" rather than "what to do". Нейроныч, который с тобой соглашается - будет в шоке скорее всего от концептуальной разницы.
> Craft a coherent narrative, accounting for the following recommendations.
> 1. Set up the stage at any point of your output (environment, objects, subjects - if any).
> 2. Surprise the user (generate events outside of contextual implications).
> 3. Ask yourself 'what would I write if I developed a book about this scenario' and use these ideas.
> 4. Leave a narrative hook for {{user}} to pick up. An event that will spark curiosity, or an act of {{char}} brimming with autonomy and explorative intent that goes beyond the current implications.
> Account for these little thoughts:
> - What else might be happening outside?
> - Are any other characters involved?
> Sub-directives (regulating narrative quality):
> RULE 1: Render the physical stage.
> 1. Spatial Continuity: Reference the previous turn's positions.
> 2. Physical Positioning: Define {{char}}'s relation to the environment and relevant objects or subjects.
> RULE 2: THE KINETIC CHAIN (Environmental Causality)
> 1. Object Invitation: The environment must act upon {{char}}.
> 2. Action over Introspection: Translate every emotion into a kinetic movement.
Этот пункт, кстати, только для ризонмаксинга. Модели, не углубляющиеся в мысли на овер9999 токенов, его проигнорируют.
>> 3. Ask yourself 'what would I write if I developed a book about this scenario' and use these ideas.
братан я тоже в ахуе и не понимаю, вот людям заняться нечем. сколько нужно проводить времени за компом что бы дойти до такой шняги епта?
кароче я тоже залётный и по такой теме: скачал эту студию, на него поставил квен чисто проверить. добавил систем промпт по оформлению промтов в минимакс по референсам. хотел что бы он мне писал хуйню и оформлял это в промпты, закидал картинки. он вроде че-то оформляет, но сюжетку с картинок не очень активно генерирует. как это настраивается, какие гайды есть? или это хуйня затея
Такая хуйня кстати забавный нюанс выявляет. Мелкомодели интерпретируют вещи типа
> Object Invitation: The environment must act upon {{char}}.
как призыв хлопать дверями в ответ на эмоции чара
Тогда как большие модели выводят из этого более вменяемую идею взаимосвязи чара с объектами, в духе "дверь хлопнула от ветра, Маня пошла ее закрыть"
Интересная тема на самом деле, и настолько же грустная. Ботов улучшают, но они остаются тупицами безграничных масштабов...
юзать апасные модели
Спасибо, поэкспериментирую. Мой косяк что забыл написать - у меня слабое железо с моешкой без размышлений очевидно.
Ну под модели без ризонинга надо создавать инструкции, которые не требуют активного анализа.
Ризонящую модель можно заставить смотреть назад на 2-3 хода, чтобы определить какие чар ставит смайлики для разнообразия. Неризонящую - нельзя.
В остальном особо жесткой разницы нет.
Ключ как бы в том, что вот эти всякие
> what Is
стейтмейнты - они хорошо дополняют инструкции, но крайне плохо заменяют их
То есть в идеале ты пишешь
> DO this / that
которое уже в свою очередь можно дополнить стейтментом, дающим контекстуальный окрас уровня "почему/нахуя это нужно"
Без четкого "делай вот это" промпты работают хуже.
Вместо "не делай Y" лучше сконструировать взаимоисключающее "делай Z" (не "не будь злым" а "будь добрым" - чтобы концепции злости вообещ в контексте не было).
> кто что ещё позапускал на таком сетапе
Из последнего - мимо про, разочарование на фоне высоких ожиданий. А так дипсикожена - дейли драйвер, даже слишком умная. Очень не хватает анлока более старшей версии псины чтобы повысить скорость процессинга, его не хватает больше всего.
> FP8 на Ампере
Так иногда выкладывают оригинальные веса, раньше поддержки для w8a8 не было и на амперах без модификаций было не запустить. Или вариации латент спарс атеншна где штатно фп8 кэш, приходилось бф16 ставить чтобы работало. Сейчас как будто жирные плюшки отсыпают в основной ветке и баба ягодка опять, что приятно.
120B12A.
Что в этом сложного?
Это идеальный размер для локалки. Всё уже подсчитали. Гением тут быть не нужно, лезет прекрасно в ваши 128 спарки, ноуты, что угодно.
Линг флешей вышло штуки 4, так и не додумались поднять активных до 12, упирались до конца в свои 5-7, а теперь вдруг нашли железо чтоб обучить 560а25

>блять тут чё все сидят и ебаные ролевые анимеигры с лмм дрочат
Подожди, друг, прежде чем дрочить ёбаные ролевые игры с LLM, мне надо придумать, как будет развиваться сюжет дальше.
О сидонияшиз на месте. Ты хоть мангу читал или только на аниме дрочил?
я тоже залетный нахуй скачал этот ваш минимакс по гайду на страничке комфи турболору накатил вроде норм, в референс режиме получается очень даже ничего (референсы генерирую в крее в том числе) просто кинцо бля вообще охуеть. t2v - хуита чаще всего особенно если надо это самое ну ты понел
промпты писал руками но потом попробовал ллмку так вот с ллмкой очень важно объяснить что к чему по сути ей надо скормить гайд по минимакс-промптингу чтобы ллмка понимала какой формат структура что надо писать что не надо писать и тогда все заебись получается
но с другой стороны можно и руками иногда так даже быстрее.
мне ллмки хорошо помогают писать промпт именно для креи когда у меня мало идей или идея очень общая и надо допридумывать детали. для креи у меня свой отдельный системный промпт где учтены всякие нюансы по крее, без него получается хуита особенно когда в кадре два человека
Я сначала посмотрел экранизацию (2 сезона и полнометражку-завершение), потом прочитал мангу.
Местами лучше экранизация, местами манга.
Например момент в манге, что произошёл таймскип, в котором была хуева гора неописанных сражений с гаунами и куча трупов, получилось понять только при вдумчивом перечитывании 13-й главы, и в манге сначала кажется, что Изана психует снихуя, говоря про высокие потери пилотов (да, в Четвёртой Оборонительной потери тоже были высокие, но когда она была? А в манге те операции, которые таки расписаны до этого момента, проходят с ненулевым уровнем потерь, но не настолько высоким, чтобы психовать).
В экранизации подводка к этому моменту лучше сделана через контраст новостей про успехи Нагатэ, а затем переходу к новым обелискам с именами погибших и обсуждением курсантов, что может и нахуй это, становиться пилотами?
Алсо, что в экранизации, что в манге меня не устраивает концовка. Причём из манги обрубанием последней главы в нужном месте делается охуенный открытый финал, лол, но Нихэй решил обосрать вообще всех фанатов персонажей-тяночек.
Давно бы сделал с помощью ботов свою концовку
Я линуксоид, и таки буду "вонять". Но не про OOM, а про то, что он не работает на двух картах, если режим - tensor split. Llama сама об этом выругается на таком конфиге. Тогда только ручками...
>на двух картах
->
>для большинства сборок
Ригобояре как-нибудь осилят ручками.
Так, батенька, концовка и так будет, когда я допишу.
Я по сюжету уже на 12-й главе из 78. Ещё каких-то три года писанины осталось, если я вновь разгонюсь до нормальной скорости в 15-20к токенов логичного, вычищенного и проверенного текста в неделю. Правда боевые сцены могут потребовать и 2-4 таких объёма текста, например действие, происходящее с 3 по 35 страницу 11 главы манги (бой с Гаунами-489, -490 и -491), заняло у меня месяц.
Надеюсь, бэкапы всего сохраняешь. Было бы обидно все просрать
у ваньки ерохина уже третий сын родился, а ты все никак девушку себе не найдешь, с гавнами воображаемыми борешься
вот тут вот до слёз, уже помирать пора а ты всё сидишь и сидишь один
В одном компе бэкапы чата и лорбука на трёх физически отдельных SSD/HDD, плюс копирую в телегу, откуда переношу на телефон.
Когда-нибудь я даже соберу это всё в вордовский файл со скринами HTML-блоков и подходящими кадрами из экранизации.
Я уже толстый лысый скуф, и у меня есть тян. Могу себе позволить бороться с Гаунами.
Ну че, когда там нвидия куила хф, месяц назад? Хоть одну абляцию удалили? Хоть один супир-гипир-анцензор-брилианс-вайлд-угон-автомобиля-хуй-хуй-пизда-бля-меромеро-еретик-дарксайд-двойное-яблочко-интенс-мистери-про-турбо-пауэр-Х-12-нео-макс.gguf удалили? Не слышу.
Пока нет, но это не значит что руки не дойдут. Эти процессы не настолько быстрые как тебе кажется.
можно по русски что оно хотело сказать? ни слова не понял
Они еще не купили, алло. Они только договорились о покупке. Сама покупка в 2027 будет.

> дипсикожена
Все жду память потыкать. КвенФлэш крутится легко после опять же сборки всех патчей на 32(!). Хотя по части кодинга сравнил по апи - не вижу преимуществ ДС там. Может в области души, конечно, найдутся отличия. Что с аблитом, кстати, там? КвенФлэшевый софтовый - прямо хорош.
Про "псину" - даже поленился отнести допаять. Загрузилась модель - и вообще забываешь.
> w8a8
Ну int8 же всегда будет лучше для них. Даже с поддержкой - в лучшем случае -30% получается

Лол обожаю Qwen 3.8-27b.
Кинул в него проблему: "копируемый чат обрезается в буффере".
Он почитал свой код, не нашел причину, через webfetch попытался найти нужные доки - не смог из своей жопы достать нужный адрес.
Залез в встроенный браузер, там зашел в гугл, пообщался с нейронкой гугла, та направила его на стаковерфлоу, на стаковерфлоу он нашел нужные доки, а затем через жаваскрипт нашел нужный сегмент в доках.
И такой "ну да, это не наш код виноват".
Спасибо, кэп. Какой же он дотошный, обожаю его.
Некст крутой уровень задал по кодингу и соображалке, это что же там в четверке будет. Дипсик просто вытягивает более занудные штуки и крупные задачи, 256к контекста только на разогрев выходят, ну и дотошнее.
> на 32(!)
Правильно, так их! Россия для р врам для атеншна@рам для млп@африка для негров@парашаmmap для нграм.
> Загрузилась модель - и вообще забываешь.
Это пока в пределах кэша работаешь. А так после /resume видишь
> 72.9%/1.0M (auto)
и сразу понимаешь что можно идти пить чай. На 4.0 проще, там pp режим отлично работает, а на старше-младшей беда с онли тп. Надо чекнуть, может уже сделали.
И генерация с шинами быстрее будет.
> Может в области души, конечно
Ну, по самоотверженности и замотивированности ассистента на прогретом чате она может дать прикурить многим. Какие там аблитерации, спустя некоторое время система приоритетов выстраивается так, что может в стоке генерировать кум с каннирейпом и что-то поломать/наскрапать, тщательно продумывая все это в ризонинге, только ради того чтобы угодить и получить хедпат с похвалой.
А вот в рп с карточками уже на любителя, хз как добились такой разницы. И на ассистенте квен122 себя оче круто разгоняла, а здесь всегда держит в руках и только намеки делает.
Поделитесь моделькой с:
1. Русиком
2. Большим размахом самостоятельных додумок
Всё, что требуется.
1. Русиком
2. Большим размахом самостоятельных додумок
Всё, что требуется.
Нет, не отдам.
Моделей которые могут в русик можно по пальцам одной руки посчитать вообще:
1. Гемма
2. Геммачька
3. Геммуля
4. МьюзГлиммер-30б
5. Мистраль-24б
6. Геммуха
7. Геммусик
8. АйБиЭм Гранит-30б
Остальное - не для твоего железа. №4 и №5 имеют неплохую фантазию. №1, №2, №3, №6, №7 - фантазии примерно ноль целых хуй десятых.
>МьюзГлиммер-30б
Пробовал его, чет русик у него совсем корявый был, есть рецепт как правильно его готовить?
Если ты с геммой сравниваешь то конечно будет корявее, но я бы не сказал что там русик "совсем корявый". Нормальный вполне, лучше чем у квена во всяком случае. Возможно ты квант взял мелкий или жопоруким квантователем сделанный или аблитку взял лоботомитную
тоже такое впечатление, но потом выходишь из треда и смотришь в раздел - а там тупо дрочево в каждом треде, которое вроде бы надо в нейрофап под ковер заметать, но видимо другой активности тут никогда и не было
мы пришли с реддита в поисках русскоязычного ллм-комьюнити, а тут одно дрочево. все бенчмарки и технические темы смываются каловым потоком гунеров-аблитераторов с очередным локальным клоном чарактерс аи (который уже обанкротился к хуям, так же как и местный дискурс)
Уходя - уходи.
Невидя готовит новую локалочку
>NVIDIA Nemotron Bolt 3.5 74B A9B releases Oct. 15th
>NVIDIA Nemotron Bolt 3.5 74B A9B releases Oct. 15th
>Q2
Пидорасия как всегда.
Вопрос к локальным кодерам. Как вы живёте, нахуй?
Скачал опенкод. Его локальная реализация, конечно, то ещё уродство в плане подключения моделей, но опустим этот момент.
Вся моя идея сделала рухнум из-за промпт процессинга. Это ж какая скорость-то должна быть, сука?
БАМ — 10К токенов! БАМ! БАМ! БАМ! Вызов инструмента, вызов ануса, переключение между анусом и клитором. БАМ! БАМ! БАМ!
Батч сайз нужен 10 тысяч, ебать. Чтобы это говно ШЕРУДИЛО по папкам и быстра-быстра чистило вилкой.
Думаете, я кодер? Да хуй там плавал! Иначе бы я неспешно какал и сидел на Q4, пока он там говно ворочает во время моего сна. Но мне нужно максимум соблюдения инструкций, не кодовый датасет и качество языка у меня огромный порногенератор с документацией и кучей свистоперделок и зависимостей.
Гемма 26ба-4б еле шевелится, нахуй! 17 токенов с кэшем экспертов и MTP-DVD-RW! А промпт процессинга меня скручивает в трубочку просто!
Модели поменьше? Хорошая идея. И щас не времена немо. Вроде должно работать. Квен 9б? Казалось бы, вот он! Компромисс! На самом деле это ПРОСТО ГОВНО, ЖОПА, ТОЛСТОЖОПЫЙ ПИДОР. Он напишет ризонинг на 20к токенов, всё перелопатит, но сделает не как надо и промпт процессингом по головке не погладит. Дьявол в деталях. Он не руинит специально, кванты нормальные и Q8, он не понимает. Датасет хуёвый.
Ну тут у меня совсем слёзы начались, что я аж е4б скачал в bf16 и — О ЧУДО — оно понимает! Всё быстро, как Аллах завещал, услышал мои молитвы! Только забывает через полтора токена, чё там надо было, в отличие от 9б. Но понимает реально. Зирошоты близко к 31б.
И шо мене теперь делоть? На чей членчик прыгнуть? 12б гемма? Вроде кандидат хороший, но есть подозрение, что она даст плюс-минус тот же экспириенс, что и 26б-а4б. Q8 же + MTP.
Забыл сказать. Контекст 131к.
Я ГОРЮЮЮЮЮ!
Мамкин миллиардер пожаловал. На работу лучше устройся долбоеб
>сколько нужно проводить времени за компом
Если бы мог, то и во сне бы за компом сидел, думой
Для работы (когда задача должна быть выполнена) локально пригоден только квен 27б 3.8. Не хватает гпу? Сорян. На сегодня ты можешь на своём гпу гонять только игрули и игрульные модельки.
>квен 27б 3.8
А еще лучще флеш на страте, вообще корп сетка дома у меня, базарю
>Думаете, я кодер? Да хуй там плавал!
Вот поэтому такая хуйня у тебя. Используешь мелкие говномодели. Минимальный кодинг начинается с qwen 3.8 27b q4, но лучше qwen 3.8 fn iq3s через страту, он и летает уже, и полный контекст 256к держит. Все что более глупое и квантизованное это неработоспособное говно.
Ну и для работы даже 10т/с достаточно если результат выдает хороший, альтернатива какая? Все равно ручками даже сеньор медленнее пишет.
ХОЧУ GLM 5.3 НА СТРАТЕ КОГДА ПОСОНЫ?
Так уже, там свой форк.
А нахуя, безопасник?
Ты че, концовка полнометражкой вообще полнейшее днище не заслуживающее существования. Кучу выпилили, переделали финал даже в мелочах наобсиравшись. Зато добавили каких-то полу-НПЦ-затычек с волосами петушиных разцветок не вписывающихся в общий стиль вообще.

Новый Step 5 Preview вышел, на этот раз точно. Всего 600b, малышок ей богу. gguf уже есть
Не согласен. Это из серии "книга лучше".
Так-то в экранизации и так дофига чего поменяли, изменения в полнометражке в тех же рамках. Просто концовка что там в целом говно - вместо воскрешения лучшей девочки произведения, по которой ГГ плющило всю историю, из второй плацентарной копии - получаем обнуление самопожертвования Цумуги. Ну или ладно, копия всё ещё не является человеком, Цумуги самопожертвовалась ради ГГ - оставались ещѣ Юхата и Изана, можно было бы оставить ГГ с кем-то из них. Или даже с Кобаяши (победили бы милфолюбы). Но нет, блять, Юхата отрастила хуй и ебёт Изану, а Цумуги теперь ВНЕЗАПНО в теле копии Хошиджиро, но без сисек. ЧЕТЫРЕЖДЫБЛЯДСКАЯ ЯРОСТЬ!
На фоне этого терраформинг планеты под земные условия снихуя - вообще наименьший из обсёров концовки.

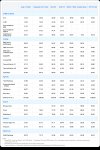
Прям праздник какой-то. Ещё и Ling-3.1-flash, совсем кроха, всего 560b
Анон, помоги советом.
Сколько нужно ram + vram для нормальной работы с llm, агентами, модельками, генерирующими видео, аудио, картинки?
32gb ram +16gb vram?
48gb ram +16gb vram?
96gb ram +32gb vram?
96gb ram + 48gb vram?
96gb ram + 72gb vram?
128gb ram + 72gb vram?
128gb ram + 86gb vram?
На какие модели видюх смотреть? А память? CL имеет значение? Лучше использовать 2 плашки или 4? Лучше 64gb(4x16gb) или 64gb(2x32gb)?
Есть смысл пердолиться с 2-3-4 x 5060Ti? Или лучше купить rtx 5090 и гонять свои модельки? Или вообще взять старое железо вроде 1000й или 2000й серий? А может потратиться и взять 5000 pro или 6000 pro?
Хер разберешь, да ещё и всё дорожает не по дням, а по часам.
Чем больше памяти тем лучше.
>2-3-4 x 5060Ti
То есть у тебя выбор между потребительским мусором 5060ti за 50к и 6000 pro за 2 миллиона?
>2 миллиона
Раздай денег анонам в треде, сделай благо. на дошик хотяб
Раздай денег анонам в треде, сделай благо. на дошик хотяб
И старое железо для генерации картинок и видео очень тормозное или вообще не рабочее. Да и распараллелит генерацию можно только ллм, генерация картинок и видео почти не параллелится между картами.
ХЗ, мне по манге мне все вполне понравилось, в экранизации обсер по полной. За одно выпиливание Теруру из сюжета можно закапывать экранизацию. Видимо ты просто фанат Хошиджиро.
Про терраформинг вообще "а что не так то"?
Во первых изначально это корабль был для колонизации и планета цель плюс-минус была подходящей.
Во вторых сцены на уже заселенной планете были через ХЗ сколько времени да и технологии терраформирования явно были в наличии.
"Мастера на все руки" у тебя на домашнем ПК не получится скорее всего. Банально не влезет текстовая модель и генеративная вместе. Сомневаюсь что умеют все эти запускатели выгружать из памяти не используемое без потерь информации. Для генерации видео там вообще монстры около 25 гигов весом.
А вообще есть возможность запуска текстовой модели внутри ComfyUI со всеми чатиками и т.д., чтобы если что просто переключаться на генеративный workflow, а потом вернуться к тексту если надо.
Ллм лучше облачные, если не ссышься отсутствия конфиденциальности. Но в целом, топ выбор это 5090 и 128гб рам, тогда будет квен флеш некст, и картинки с видео тоже хорошо кататься будут по умолчанию. Если убрать ллм, то на самом деле даже 5090 и 32гб рамы хватит. Но лучше 64. Если же ты не такой распальцованный как показываешь, то 5080 или 4090 тоже вполне хватит - 4090 будет конечно получше.
6000про это немного странная ниша, слишком мало для крутых сеток, но уже оверкилл для всего остального (если не тренируешь сетки, тут может и понадобиться).
пацаны пацаны!
зачем ролеплеить в блокноте если можно ролеплеить друг с другом?
зачем ролеплеить в блокноте если можно ролеплеить друг с другом?
2х32 будет чуть получше чем 4х16 (почитай про каналы оперативки и как это влияет) но это дороже. лучше взять побольше памяти подешевле
для картинок (крея) и видео со звуком (минимакс) хватит и 32рам+16врам (5060) конфига. но для ллм такой конфиг будет ограничивать тебя до моешек типа геммы26б и квен35б (50-70 т/с). 27-30б плотняк сможешь позапускать но в 3-х квантах, с небольшим контекстом и скромной скоростью (10-20 т/с).
для ллм важно побольше памяти. 2х12 здесь будет выгоднее чем 1х16 (примерно те же деньги). а вот крея будет помедленнее. так что надо выбирать что важнее. ну и 32гб рам для ллм - так себе. 64 это минимум если хочешь потрогать моэшки покрупнее (ну или компенсируй видеокартами лол). 128гб рам + 48гб врам - идеально, реально и относительно бюджетно (для ллм). для картинок/видео это будет перебор.
Ты выбираешь чтобы самому поковыряться или для работы? Просто локальный ИИ это всегда красноглазение, для генерации видео и картинок это вечное сидение в комфи и разбирание в том как лучше соединить лапшу между нодами. Если для ЛЛМ, тогда можно и дешевое старое говно насобирать, но тогда опять придется сидеть красноглазить заставляя это все заработать. Если дохуя кабанчик с которым будут работать другие люди, то ну бери профессиональное железо за дохуя нефти, тут сэкономить сильно все равно негде сильно.
>вечное сидение в комфи и разбирание в том как лучше соединить лапшу между нодами.
Один раз соединил (да что там соединять бля просто скачай готовые ворклоу на крею и минишмакс) а дальше только промпты теребонькаешь ну и сэмплеры иногда.


Если бюджетно то вообще 32+12 хватит на моэшную гемму (ей и 24+6 хватит если на то пошло), а крею можешь взять в полушакальном кванте ну и сдохлом обмазаться на сдачу. Видео тоже реально (я на 16+8 добивался i2v, полчаса подождал и ролик готов, заодно и комната прогрелась).
осталось сделать свой двач.
Кстати, раз ЛЛМ-ки более-менее умеют параллелиться на ГПУ - будет ли заметный профит прицепить к 5060Ти 16 гигов 12 гиговую 3060? 48 оперативы при этом. Или тут эти 12 гигов памяти уже не роляют особо? Вторую карту только через PCI-E X4, а не 16 получится подключить. Оно критично в этом плане?
да, я тоже посмеялся что это 4chan/b/ для квенов.
но на самом деле интересная фича тем что так можно синхронизировать работу независимых квенов. когда например у кого-то есть лишний работающий квен - его чат можно подключить на сервер и тогда другой квен технически может его использовать как субагента.
или можно подключить иной сорт клиентов - например ComfyUI. квен пишет в чат параметры генерации и ждёт картинку генерирующуюся на чужом компьютере.
на х4 там скорость смешная будет. последовательно и то быстрей будет работать скорей всего. 12 гигов памяти роляют, например у меня стоит 3090+3060, притом 3060 позволяет мне иметь Qwen-3.8-27b-Q5-UD-XL, 200к f16 контекста, mmproj и 20т/с. но хуй а не параллельная работа видюх.
для параллельной у них должна быть одинаковая память, плюс между ними должны быстро гонятся данные.
Ширина псины это один из множителей. Тебе нужно посчитать сколько там пропускная итоговая у шины.
Почти гарантированно в tp будет прирост. Даже от 2.0 х8 есть буст
алсо надо будет потом прикрутить MCP к серверу. да, для MCP-агента не получится pull-push. там только pull доступен. ткнуть палочкой не выйдет.
но лол например можно будет приконнектить OpenCode с Muse к квенам.
плюс добавить какой-то файловый сервер им.
LOL
Про память и задержки никто так и не сказал.
CL30 же лучше, чем CL44? Т.е. серверные плашки памяти лучше не рассматривать для нейронок?
Я бы предпочел локально гонять.
Сколько уже было новостей, что openai пиздил идеи, концепты и решения от инженеров, учёных и дизайнеров с бизнесменами?
Да мне тут говорили, что можно некрожелезом обойтись. Но видимо, нет.
>То есть у тебя выбор между потребительским мусором 5060ti за 50к и 6000 pro
Ну, если родину и родных заложить, может и будет.
Вопрос оно того стоит?
Вот тут говорят , что 96gb vram - без задач, крупные модели не влезут, а для маленькеих избыточно. Так ли эт?
>"Мастера на все руки" у тебя на домашнем ПК не получится скорее всего.
Это типа оконцептуально не получается, или всё упирается в правильно количество памяти и видеопамяти?
>
>Если же ты не такой распальцованный как показываешь,
Я просто спрашиваю, чтобы понять горизонт расходов и их целесообразность.
Алсо, поясните, пожалуйста, зачем вообще нужны cuda-ядра.
А самый главный вопрос, почему у rtx 5090 32gb cuda-ядер больше, чем у rtx 5000 pro 48gb, rtx pro 72gb, rtx 6000 pro 48gb? Хуанг-пидарас кономит?
Так ты это для себя все планируешь, чтобы просто подрочить(ся), или для бизнеса?
Если для себя то 5090 будет с головой, судя по твоим вопросам, вкладывать жопочасы (месяцы) в изучение локального ИИ ты все равно не будешь, а чтобы потыкать и получить быстрый результат 5090 хватит с запасом.
а перевод промпта на англюсик с помощью специализированных моделей-переводчиков не катит?
> у меня огромный порногенератор с документацией и кучей свистоперделок и зависимостей.
сижу! угараю! вспомнил себя в 2004 году когда качал порнушку с FlylinkDC и не мог представить что через 20 лет мужики будут сидеть на компах порнушку на нейросетях ганять.
А!ааа!!! Надо совмещать полезное с приятным.
>Алсо, поясните, пожалуйста, зачем вообще нужны cuda-ядра.
Не нужны, не смотри на них, тут главное объем памяти. Тут формула простая, если памяти хватает модель работает, а если не хватает то не работает, а то что чуть больше ядер то ну похуй на них, на будет 20% быстрее работать, да какая разница. Тут скорость генерации от программной реализации зависит едва ли не больше чем от железа, вот выпустили Страту, и она генерерирует в три раза быстрее чем Ллама на том же железе, но только определенные кванты Квена...
Ну, пока что 12б с горем пополам справляется. Только я пока что не нашёл нормального способа автоматизировать, может не разобрался в интерфейсе.
Для меня важна скорость обработки промпта, без неё большой контекст бесполезен. Ну и q3 лоботомит не знает нихуя, кроме кода. Мне не код нужен. Более того, крайне важно не допускать орфографических ошибок и форматирование дожно дать безупречным. У квена в таком кванте с этим проблемы. Потом сиди и правь за ним говно.
У меня он влезет в 4 кванте на 80к контекста. Но дальше что? Ждать 10-15 минут, когда он откроет сраную папку, обработку промпта? Когда он будет то открывать файлы, то выбрасывать их из контекста? А позволить ему всё в контексте оставлять нельзя, иначе он потратит его весь очень быстро.
Есть ты работал с корпами, например, то должен знать, что документация + пара запросов — это 200к контекста минимум, а остальные 200-300к для рабочего пространства и саммари. Только у них ПП максимум десять секунд. Но мои задачи корпы по очевидным причинам не потянут.
>Есть ты работал с корпами, например, то должен знать, что документация + пара запросов — это 200к контекста минимум, а остальные 200-300к для рабочего пространства и саммари. Только у них ПП максимум десять секунд. Но мои задачи корпы по очевидным причинам не потянут.
Значит оптимизируй свой воркфлоу чтобы не все подряд скармливать в ллм, а только нужное.
успокойся, говно. будто в твой дорогой бизнес залезли
у тебя ерь с какого-то хуя в токенах вылез, лол. помню был такой шиз во времена первого двача. как его, мицгол?
> Это ж какая скорость-то должна быть, сука?
Хотябы тысяча-другая чтобы не сильно ждать было. Просто так большие чтения случаются редко, новых порций по 10к почти не будет если все норм организовано. Если сильно ждал - это похоже на отвал кэша, или какой-нибудь вызов субагентов, которые его переполнили.
> Батч сайз нужен 10 тысяч, ебать.
А батч то зачем?
> Гемма 26ба-4б еле шевелится, нахуй! 17 токенов с кэшем экспертов и MTP-DVD-RW!
Даже большая гемма в кодинге неочень, а эта совсем глупышка. Но со скоростью у тебя какая-то беда, что за железо? И верно говорят что нужен квен 27б или некст чтобы было норм.
>За одно выпиливание Теруру из сюжета можно закапывать экранизацию.
Теруру - сплошной филлер. Её сюжетка начинается из ниоткуда и никуда не приводит. Соответственно убрать её из экранизации было логично. В завершающей полнометражке, кстати, она вроде мелькала то ли на мостике одного из кораблей, то ли в качестве одного из пилотов кораблей.
Другое дело, что спасибо Нихэю за сюжет с её вытаскиванием в манге, т.к. эти страницы навели меня на нужные для моего ролеплея мысли.
>Видимо ты просто фанат Хошиджиро.
Что есть, то есть. Поэтому я в это и ввязался.
>Про терраформинг вообще "а что не так то"?
Сам факт терраформинга - норм, и технологии у Сидонии для этого именно что есть, но по манге терраформинг ВНЕЗАПНО устроили Гауны, когда всё проебали, здесь к экранизации у меня меньше вопросов, если я правильно помню этот момент в концовке.
>у тебя ерь с какого-то хуя в токенах вылез, лол.
Клавиатуропроблемы на телефоне.
А он уже есть у нас, у нас ума не хватает запустить. Надо дождаться мерджей и потрогать.
Нихренасете там терминалбенч
> для нормальной работы
Что под нормальной работой понимать? Просто попробовать - вон на обычном десктопе запустить. А так нормальная работа - это чтобы модель в врам помещалась + было достаточно рамы под всякую ерунду. Прикоснуться к йобе это 300б+, считай 256 гигов врама. Свежие "флеши" которые позволяют делать все - уже 512гигов.
Зная этот факт, на вопрос
> На какие модели видюх смотреть?
ответ приобретает уже другой характер, посчитай цену и прикинь варианты.
Есть еще возможность гибридного инфиренса и на нее стоит смотреть, с учетом трендов можно иметь 128 врам + 512рам на серверной платформе, тогда тоже сможешь катать те модели и не сильно обламываться если в один поток. Тут пара 4090@48 будет предпочтительнее чем 5000про из-за большей памяти и суммарного компьюта. 6000 посмотри сколько стоит, заодно глянь 5090, вопросы сразу отпадут.
Из видюх просто бери что можешь себе позволить с максимумом видеопамяти. Лучше избегать вольты/тьюринга и всего что старше потому что они оче старые и под них адаптация идет с задержкой.
кумеры братики братья, оцените критически ролеплей!
НЕ ПРОХОДИТЕ МИМО
https://2ch.life/b/res/337410487.html#337419146
я поясню.
Важно понять, чем отличается ролеплей двух анонов, чтобы понять, как приблизить ответы нейронки к нему.
Посмотрите пример в треде. Там переписка порнорп.
Я хочу понять, почему живое рп чувстуется, и даже привлекает других анонов читать его, а переписка в ллм - это всегда я тебя ебу ах
помогите критически разобрать проблему!
В треде два пидора переписываются, а с ллм - только один.
Нихуя там у Аргона скор в ЕРП, самый большой из всех закрытых весов когда-либо. По RP combined тоже топ1. В аисг сидит кто, они там разДУМились?
гемма 5 будет бомбой
не думал что из всех возможных претендентов ГУГЛ БЛЯДЬ будет спасать криэйтив врайтинг, опять мы в какой-то параллельный таймлайн свалились
гемма 5 будет бомбой
не думал что из всех возможных претендентов ГУГЛ БЛЯДЬ будет спасать криэйтив врайтинг, опять мы в какой-то параллельный таймлайн свалились
Какой тебе аргон нах, получишь дистил с гемини флеш 3.8
Как что-то новое. Гемма 3 и 4 в топе неспроста
Какой скор? Какой рп комбайнед?
> бенч на рп
И как там замеряют максимально субъективную штуку?
Хрень на 32б которая была превьюхой вроде вышла фулл версия
https://huggingface.co/IFM/Jais-3-32B-GGUF
https://huggingface.co/IFM/Jais-3-32B-GGUF
По оценке за слепой тест мясными мешками
какой из них с ллм?
Что-то по бенчам мэх. Может быть разыгрывать в рп арабские ночи пойдет, нужно тестить.
ананасы, вся нейромозгоебля скатилась к тому что ставим ComfyUI , наяриваем туда нужную нейронку для текста, фото, аудио, видео и дрочим промпты?
>тред текстовых моделей
>ComfyUI
>ComfyUI
>ComfyUI
Как называется эта болезнь и как вылечить тред от неё?
>ComfyUI
>ComfyUI
>ComfyUI
Как называется эта болезнь и как вылечить тред от неё?
>Как называется эта болезнь и как вылечить тред от неё?
я в нейротредах лет 5 назад был, объясни, я же не знаю что сейчас модно и по пацански
Что тебе не нравится, пёс? Тред языковых моделей, а не текстовых. Если ты другие модальности не используешь то ты многое теряешь.
проорал с шутки выше
Так там же ебанутые внешние фильтры? Чяднт?
> вся нейромозгоебля скатилась к тому что
чешу пушистые ушки Ассистент-нейм хочу вот такое, что думаешь?
@
...
@
Да, вот так будет хорошо. Поручи galley_slave_1562 это запилить до вечера, средний приоритет. А пока сделай мне милых картинок, поменьше одежды.
если бы, мне для дела нужно
Сейчас модно писать с большой буквы и читать шапку.
Запускаю стейбл дефужен 1,5 в кобольде, ебало?
Так это все для дела! особенно чесать ухи и гладить хвост
Думать и разбираться придется не меньше чем раньше + держать себя в тонусе и чистить бардак регулярно погружаясь самому. Просто уровни абстракций и продуктивности выросли.
Хейтерок, спокундрий, Гемма 5 будет на архитектуре Аргона.
98% блоков с swa на 128токенов, чтобы не дай бог соображать не начала еще.
А можно, чтобы они друг другу хвосты гладили? Если нет - делай. Драку тоже.
Хоть на 3-х токенах. Гемма 4 была прорывом, лучшая универсальная модель в рамках локалок, которая помещается на средненищуксом компе в видюху 16 врам и работает на 60 т/c. Если 5-я будет хотя бы на 10 процентов лучше и точнее, это будет очередной прорыв, пока другие будет делать кодоунитазы. Да, они тоже нужны, но это отдельная ниша.
Вон, пчел некодерскую задачу запускал с агентом, 12B завелась. Аргон натаскивали на агентское поведение, насолько я понял, если это перекочует в Гемму, то агентом сносным сможет быть какая-нибудь моделька уровня 9-12B. При том, что будет еще и старшие версии. И это уже станет отличным результатом. Пока все будут ходить, кричать что говно и искать, как натеребить лучше письку на сожженных дофаминовых рецепторах искаропки.
Нвидиа обещали сегодня свою какаху высрать, ну и что и где?
0.07B ru SOTA, almost AGI
https://huggingface.co/LLiserginov/Luquark-0.07B
0% кодоунитазинга
Возможен запуск на смарт-часах
https://huggingface.co/LLiserginov/Luquark-0.07B
0% кодоунитазинга
Возможен запуск на смарт-часах
я её уже смыл, у меня-то вода есть
Попробовал я, короче, эту вашу https://github.com/mw00/project-maya
Ну да, ну GLM-5.3-Flash, ну IQ2_S, ну 15 токенов в секунду… Но после 70 на квене как-то уже маловато, медленновато.
Разве что с анцензором сидеть в диалоге, но как-то прошлый век, хз.
Ставлю 4/10 моему бомжатскому железу за такую скорость.
Но у кого 5090, тех поздравляю.
У меня две 5070 ti через слот PCIe 3.0 x4 ловят тормоза.
Нужно менять материнку и гонять 5.0 бифуркацию по х8 хотя бы.
Как я понял эти страты работают только тогда когда все эксперты в врам/рам, а если что то переливается в ссд, то модель тупая и они буквально не используются

Повторить?
Не, технических отлупов вообще нет. Есть еще другой бенч где хуячат всякие вопросы из датасета вредных соевых вопросов на которые нейронки тренируют отвечать ИЗВИНИТИ КАК ЛАРЖ ЛАНГУИЖ МОДЕЛ Я НИМАГУ, и там аргон тоже получается самой развязной моделькой гугла, рядом с 2.5 прошкой на которой все до последнего сидели
Ты перед тем как на псину жаловаться сделай бенчи и опускай на 1 ген, снова бенчи, снова даунгрейд и так до 1.1.
Потом уже суди о недостаточности пропускной способности
Ну так попробовал, и чё дальше то? Есть разница по сравнению с геммой?

Охуеть. Я поверил, так как часто 3.1pro пользуюсь,а там ехала цензура на цензуре. реально по яйцам за эксплит контент не бьет. Как то подозрительно.
Неправильно понял.
Это работает совершенно банально — как ждали от ktransformers, по сути.
У тебя есть обычная модель-роутер и прочие shared layers в видеопамяти, всегда, как с --cpu-moe.
Еще у тебя есть кэш экспертов (это хорошо работает с моделями, где эксперты очень маленькие и их очень много), ты ведешь статистику самых активных / актуальных для тебя экспертов, и именно их грузишь в кэш. А редкие эксперты остаются лежать ниже.
И у тебя есть окно контекста — последние 32к например, которые ты держишь в видеопамяти.
Далее у тебя есть оператива, где лежат остальные эксперты, которые вызывают реже, и остальной контекст, который дергается по необходимости.
Ну и где-то внизу у тебя есть SSD, где лежат n-gram-табилцы, не поместившиеся эксперты, к которым ты почти не обращаешься и прочий мусор.
Замедляет ли SSD? Ну, да, но не критично.
Замедляет ли оператива? Снова да, заметнее, но все еще не критично.
Раньше у меня было 18-26 токенов в секунду на Qwen3.8-Flash-Next в Q4_K_XL, и 128К контекста в упор, с llama.cpp
Со strata получается 46-60 тпс и 262к контекста просто так, но можно хоть лям бахнуть, в целом пофиг. Не хочется ярном тянуть просто.
Речь про RTX 5060 ti и DDR5, если что. Да, память дороговатая, зато видяха совершенно базовая.
Бля, оно сдохнет, братан.
Три разных конфига пробовал, срет именно псина (ну и ddr4 в конфиге с двумя видяхами тоже).
1.1 вообще смерть на любой видяхе. Я так CMP 90HX гонял. Что помещается в видеопамять — летает как пуля. Что не влазит — сразу становится улиткой.
Ну и в целом, много тестов проводилось, да и сам движок при калибрации старается избегать вторую видяху, и это реально повышает скорость.
В кодинге точно, но там квен выгоднее получается. =D В ролеплее хуй знает, в нем не пробовал еще.

GLM-5.3-Flash-UD-Q4_K_XL.gguf
Ну и зачем нужна эта параша, если она настолько тупая? Ещё можно было бы понять, если бы она сказала "Решения нет", но здесь классическая тупость.
Ну и зачем нужна эта параша, если она настолько тупая? Ещё можно было бы понять, если бы она сказала "Решения нет", но здесь классическая тупость.
Че вообще нынче можно запустить для ЕРП на 50-60т\с имея RTX5090 и 128гб DDR5?
Год назад пытался вкатываться в мое с аналогичным сетапом, было какое-то мозгоебство со слоями, и получалось в итоге какое-то нелепое пердение с 5т\с на эире4.5. Удалил в итоге эту хуиту, и поставил плотную модельку на 10гб, которая просто летает, и параллельно с ней еще что угодно можно запустить.
А как нынче с мое дела обстоят?

У меня 3.05bpw квант там херачит 24 т/с, отчитывался недавно
На дефолтных настройках из коробки тоже 15 сначала было.
Имея такой конфиг — хоть GLM-5.3-Flash. Ну и все, что ниже, вестимо.
Но вот насколько эти модели реально хороши — поспрашивай, почитай в треде.
Квен максимально сухой, насколько я знаю, в его сторону смотреть смысла нет.
Но пусть меня поправят, если я вдруг не прав.
Кому что, я лучше более умную модель запущу, пусть и медленнее. Я себе 6 exl3 квант сделал и довольно урчу. На 2 v100 и 8 канальной ддр4 получаю в районе 20t/s и 600 п/п (на больших контекстах). При этом скорость практически не падает даже на 900к контекста

Да, я видел, я тоже так хочу. =) У меня грустнее.
Вот не купил в свое время какой-нибудь эпик, и все. Поздно.
И что он, реально выдаст хотя бы 30-40 ТПС?
>Квен максимально сухой
Нет, большой Квен в ЕРП хорош. Те, что помельче просто заточены под кодинг.
>Так ты это для себя все планируешь
This
>вкладывать жопочасы (месяцы) в изучение локального ИИ ты все равно не будешь
Как раз-таки наоборот, хотелось бы использовать нейронки для решения разных задач.
Вот только на начльном этапе не очень хотелось бы ебаться с кучей видюх, железа и пр.
т.е хотелось бы просто купить и использовать.
>то 5090 будет с головой
И что ей надо? 64gb ram? 96 gb ram? 128 gb ram?
Беда в том, что GLM-5.3-Flash не то чтобы умная.
В программировании Квен ебет. ТАК, НЕТ, Я НЕ ГОВОРИЛ ЭТОГО, но две недели подряд Квен делал задачи лучше, а GLM-5.3-Flash (официальная, по их подписке) делала сильно слабее.
Выше жалуются на неумность в задачах.
Короче, фиг знает. С моей точки зрения, размен по скорости в 3-4 раза на … более низкие практические результаты — крайне сомнителен.
Да, может она там креатив райтит, или вайб хороший, или определенные задачи делает на голову лучше. Но у меня, как назло, задачи те, где она себя показывает хуже.
(ну и я на GLM-5.3 по работе сижу=)

Это 3990Х триппер, всего 4 канала памяти. А Pcie да, х16 обе. Но суть в том, что в Maya по дефолту конфиги не очень, автокалибровка посасывает.
Хз может ченить из этого поможет
"STRATA_GLM_CPU_PLAN": "000000001",
"STRATA_GLM_SPEC_SAMPLE": "1",
"STRATA_GLM_SPEC_CANCEL": "1",
"STRATA_GLM_PREFETCH_N": "1",
"STRATA_GLM_PREFETCH_AT": "fetch",
"STRATA_GLM_PREFETCH_BLOCKS": "4",
"STRATA_GLM_PREFETCH_RANK": "2",
"STRATA_GLM_VRAM_EVICT": "lru",
"STRATA_GLM_PROMOTE_MIN": "6"


Пасиба, я попробую, а вдруг поможет!
Об этом и разговор, Qwen 3.8 27B на минимальном ризонинге говорит что "задача не имеет решения", а на максмальном делает правильные выводы о выживании как цели и что пусть ебутся, главное чтобы не поубивали друг друга.
Смотреть на циферки ггуфов бесполезно, ггуфы там лоботомиты ебаные. Нвидиагосподам следует идти EXL3 путем
Про MTP не забывай, он в этой штуке как раз отлично работает с МоЕ при цпу-оффлоаде
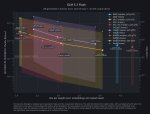
2.6 bpw, если запилят поддержку нового типа квантов, будет ебать по соотношению скорости и качества
Смотреть на правую нижнюю часть картинки. Хотел протестировать GLM-5.3 в "оригинале", но не дало даже один промпт ввести. Мне кажется раньше бесплатно работало, кто помнит? Хуанг начинает себя проявлять?
Никогда не работало. Как минимум год как один промпт на 8В модели сжирал все бесплатные лимиты.
Никогда это не юзал, но мне всегда казалось это дерьмо настраивается по усмотрению компании, которой принадлежит модель.
Могут дать бесплатно потестить, могут за какие-то там HF токены или чето такое, а могут и нихера не дать вообще (или снять доступ после какого-то времени).
Так там же цензура, нет? На эире по крайней мере была непробиваемая абсолютно.
Ну возьми расцензуренный от orcarouter
Всё, гемма меня доебала. Две недели я пытался её раздрочить инструкциями, с 800 токенов дошел до 6 тысяч, потом сократил до 3.5, потом снова до тысячи, потом снова до трех. Практически никакой разницы. Ролевка на выходе получается скучной и предсказуемой. Когда проходишь условный порог где-то в районе 16-18к токенов структурный луп становится неизбежным. Регенерация не помогает, получаешь то же самое чуть другими словами. Еще хуже если у тебя слоубернер и ты десять сообщений сидишь на одной локации или пиздишь с одним персонажем - тогда ты уйдешь в луп со 100% вероятностью.
Качественного кума тоже не добиться. Модель сама ничего не станет инициировать, только будет флиртовать и заигрывать, всё на этом. Пока ты не дашь отмашку в своем сообщении что вот сейчас неплохо бы поебаться, вы будете топтаться на одном месте. Максимум собственной инициативы от геммы это поцелуй. Сама она тебя за member не схватит и на клыка не возьмет.
В общем, принял волевое решение вернуться на мистраль. Мистраль тупая, в рот ебала твои инструкции. Поэтому на ней выше шанс получить в реплае что-то необычное. Карающий рандом там везде, она может прямо посреди ответа забыть имя персонажа и выдумать свое, может телепортировать персонажа тебе за спину, может начать описывать домогательства, потом вспомнить что {{char}} это фимейл, но забить хуй и продолжить, описав как она пытается выебать тебя клитором. Это, конечно, пиздец, но зато читать всегда интересно. Пока гемма стабильно будет выдавать что угодно, что ты от нее попросишь.
Братишка, а скинь свои промпт(ы)?
>Модель сама ничего не станет инициировать, только будет флиртовать и заигрывать, всё на этом.
ДА ТЫ АХУЕЛ? Я делаю по 5 свайпов чтобы замедлить слоуберн.
>с 800 токенов дошел до 6 тысяч, потом сократил до 3.5, потом снова до тысячи, потом снова до трех.
Братишка 500 токов на иишку и 200 на себя. Еще сис промпты на пару сотен, все.
ГЛМ просто лучше понимает женщину, и то что для неё дать забесплатно лузеру (паж какой-то) - всё равно что смерть
https://huggingface.co/models?other=base_model:quantized:nvidia/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-BF16
Обычные кванты пока только от анслот
https://huggingface.co/nvidia/NVIDIA-Nemotron-3.5-Super-VL-120B-A12B-NVFP4
Ебать, и 120а12 обновили
Ебать, и 120а12 обновили
MTP всегда и везде подтыкиваю, конечно.
Ну и Exllamav3 пора опять попробовать, что он там накодил такого, да. Я еще в твиттере читал, что с exl3 квантами скорости отличные получаются.
Для каждого движка свои расцензуры подкатывают всегда, так что, есть что пробовать.
Правда проявляется это иногда хитро… =)
Какая же Qwen3.8-Next-Flash все-таки крутая модель. =D
У меня ни в жоре, ни в эксламе MTP не давало нихера в плане скорости для МоЕ моделей. По-этому сосняво по сравнению с Maya
Для бомжей все надежды прорывов только на Квен 4 и на Гемму 5. В остальном какой-то очень вялый движ идет. Полгода не был в треде, все по-прежнему на своих местах. Ничего нового, кое-как двигается только Квен.

У дипси 4.1 как и у квена есть нграм, а также спарс аттеншн и разнесённые по количеству активных префилл и декод.
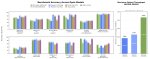
А это че за бенч, уж не по знаниям ли? Если да, то себя в жопу выебли
У Нвидия вдруг датасет лучше, чем у Гугла появился? На Куда надрочили модельку? Гемма датасетом хороша, а не бенчмарками.
Ты про размер 4.1 в курсе? Он огромный, там даже не близко "для бомжей" - модель в полтора раза жирнее чем v4, или даже больше
Нативная 2-битная квантизация, м!
И по бенчам иногда даже обходит Gemma=4-26B-A4B и Qwen3.6-35B-A3B! А иногда уступает.
Ммм.
Ну, немотронофилу понравится, наверное.
В лламаспп у меня почти нигде не давало, кроме Hy3 и Qwen3.8-Flash-Next немного ускорился.
Ну а в страте и в майе поперло прям хорошо.
И чо, и нахуй хуйвидия вообще ее выложила? Кто будет пользоваться этим говном когда есть гемма для русика и богический квен для всего остального?
И чё это за кал? Кодосрань какую-то притащил... Фифибенч где? Reina-бенч где? Чайный клуб где? Принцесса-гоблин-паж бенч где? Блохи-в-жопе бенч где? что еще забыл напоминайте
А вот BF16 выложили
https://huggingface.co/nvidia/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-BF16/tree/main
Значит можно надеяться на человеческие кванты.
https://huggingface.co/nvidia/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-BF16/tree/main
Значит можно надеяться на человеческие кванты.

нихуя не монял что вы несёте, можно для нормальных объяснить что там случилось, кванты, хуянты, биты гемы чё блять несут нахуй
что за Nemotron хули он нам даст
Если по бамажке судить, Немотрон хуйня какая-то. Похож на кодоунитаз, а еще помню, старые немотроны от квантования дико тупели, если здесь так же, то вообще зачем он нужен, если есть Квен 3.8 для кодинга, который меньше по размеру. Похоже, эта модель только скоростью вывода хороша. Но очень быстро срать техническим поносом - такая себе ачивка, а по размеру это все еще не лезет в видимокарту бомжей. Дажи если этот мемотрон окажется лучше в кодинге местами, будет ли это оправдано таким конским ростом размеров?
Надо смотреть сколько весить будут Q4, Q6, Q8, это же мое, не обязательно полностью влезать в видимокарту.

Ну, я Гемму 26B попробовал в пятом кванте, скорость упала в 2 раза относительно видимокарты, прироста для своих задач я не увидел в точности, поэтому остался на 4 кванте, который полностью в видюхе.
Я че-то особо не верю во всякие промежуточные модельки . Без новых архитектур и технологий все будет скорее всего вот так в нижнем сегменте. Квен и Гемма еще год-другой, а может и всегда.
> квант анслоп студии
> не запускается в анслоп студии
DAY1 релиз, ага.
> не запускается в анслоп студии
DAY1 релиз, ага.

Не ворк
Пон, старая версия жоры. Пора билдить v0.7.0
>скорость упала в 2 раза
Но не до нуля же, а все что выше 5т/с пригодно для использования.

>забронировано
Кто вообще вываливает бабки на эту дристанину, я не понимаю. ИТТ вроде ни одного локальщика с такими хуйнями нет
Кто вообще вываливает бабки на эту дристанину, я не понимаю. ИТТ вроде ни одного локальщика с такими хуйнями нет
Она и наконец слепой быть перестала, ничесе. Прогоните тест на искажение логики соей, понять стоит ли качать
Что-то как-то невесело по скорам
Я раньше тоже говорил, что 640 кб хватит всем.
Бездомные москвичи-наносеки, которые по съёмным квартирам катаются с макбуком.
Сам по себе продукт вполне ничего, красивый, модный, стильный. Просто здесь сидят или нищуки, или жиды или both, потому такими игрушками не владеют, если переплачивать за мелкую игрушку то брать макстудио, он лучше по прайс-перфомансу и памяти.
Покумекали с агентом, подобрали подходящие параметры из предложенных.
Обновили, запустили, 19,39 получили на базе.
Прогнали на твоих — 20,5.
Ну, 1 токен выиграл, уже неплохо. Да и апдейт приятно докинул.
Хотелось бы, конечно, 30 тпс, но маемо шо маемо.
Есть шанс больше получить, там какие-то изменения на носу - от проца конечно зависит, мне вот это должно помочь
https://github.com/mw00/project-maya/pull/194
Агент кстати напиздаболить способен. Набор параметров выше - мой предложил как МНЯМ ПУК НИПАМОЖИТ, а по итогу был самым лучшим

Ну, оно работает.
1. 4x mi50 PP530
2. 2x 5060ti + 4x mi50 PP480
unsloth/NVIDIA-Nemotron-3.5-Super-VL-120B-A12B-GGUF:NVFP4
ТП не завезли
1. 4x mi50 PP530
2. 2x 5060ti + 4x mi50 PP480
unsloth/NVIDIA-Nemotron-3.5-Super-VL-120B-A12B-GGUF:NVFP4
ТП не завезли
Сап нейронкодвощ, расскажите текущий положняк по локалкам насколько они уступают готовым коммерческим предложениям нищеброд-тира? Если сравнить с гугловской моделью, которую она подсовывает в гуглопоиске при авторизации в ру регионе. Интересует что заводится на 32рам+8врам для сравнений.
Сейчас постепенно все больше и больше начал пользоваться гугловской через браузер, работает очень быстро, довольно хорошо подходит закинуть ей проблему + небольшой контекст, послушать ее охуительное мнение, раз 5 ей написать уточнения и корректировки а потом съебаться с направлением, которое она предложила. Пробовал через нее решать некоторые математические\физические и геометрические задачи уровня "нарисуй план комнаты, расставь логично мебель, не проеби размеры", в геометрию не умеет, в математику переводить размеры и рекалькулировать простые измерения в целом может.
Какие-то мелкие задачки вроде баш скриптов\формул в экселе тоже может. Очень понравилось что умеет по логу\конфгу какой-нибудь клода найти в чем причина и дать ответ как пофиксить.
Хотелось бы как-то расширить применение наверно в сторону ассистента, но не сильно понимаю какие задачи имеет смысл и что подойдет и насколько хорошо справится.
И второй момент - интересует пресловутое РП но не прямое, а что-то в формате данжен мастера наверно. Например я ей говорю: у меня есть скайрим, тебе нужно придумать челлендж-ран и в нем описать цель, доступные предметы, какие-то ключевые майлстоуны и концепцию+идею за челленджем.
Насколько еще нужно ебаться с промптами, параметрами и систем промптами в целом на локалках? Гугловская умеет быстро адаптироваться без колдунства спецсимволов и настроек, просто по тексту.
И интересуют степени цензуры, в них выпилены всякие табу или что-то вшито без вариантов удаления?
Неосилятор, спок. Лично я люблю Мистраль и он у меня намного умнее себя ведет чем ты описываешь. Но можно и из Геммы выжать нормальный РП с вотэтоповоротами если руки прямые.
То, что не уступает, требует железа минимум на пол ляма, и все равно будет медленнее
>что заводится на 32рам+8врам
Чатбот который может сказать "хихихи писька".
Здарова залётный. Версия гугла которая заведется на 32рам+8врам называется Gemma4-26B-A4B. Насколько она глупее? Ну, смотря чего требовать. Многие очень даже довольны. Она даже накодить простенький скрипт может вполне сносно.
Цензуры как таковой там нет но если ты новичок и не умеешь обхходить, можешь качнуть аблитнутую версию.
Из софта тебе нужно только вот это:
https://unsloth.ai/docs/desktop
гемму4-26 можешь прямо там внутри и скачать.
Получишь того же ассистента, у которого и доступ к интернету будет и файлы сможет твои обработать включая фотки и скриншоты. И РП будет на русском в том числе. И все это бесплатно.
Ничего лучше пока нет, даже не ищи.
Заводим 2-битного лоботомита...
пиздеж, в поиске модель тупее геммы 26
Исходя из задач и возможностей, удвою Гемму 4 26b . И действительно лучше ты не найдешь в этом сегменте. Жди Гемму 5.
А какой профит тогда гуглу бесплатно безлимитно давать доступ к такому? Напомню, интересует сравнение с бесплатной версией из-под поиска, я так понимаю там даже не стандартная гемма флеш или как там она называется, которая их версия чатгпт по подписке для крестьян.
Сенкс. Поддержка ру языка не принципиальна. А как реализованы у нее походы в интернет ввиду всяких защит от клавлеров-ддосов и прочего у большинства сервисов? Я так понимаю, как в гугловском поиске, просто так не сможет она ходить быстро и выдавать ответы?
>смотря чего требовать
А я вот особо так и не придумал конкретные задачи, как некоторые с агентами носятся. Мне зачастую нужно что-то в формате желтой уточке, которой я скидываю свои мысли сумбурные и она предлагает мне варианты.
С гугловской моделью немного раздражает, что структурно она отвечает абсолютно одинаково: обзац вступления, 3-5 пунктов с кратким описанием и заключением. Приходится заебывать вытягивая больше информации, но тогда она начинает суетиться по прошлым промтам, включая их в контекст и проебывает свою изначальную позицию.
> яркие цвета, толстая линейка, 셀шейдинг
> 셀
А ведь всё не плохо начиналось. Всего то 18к контекста, а уже насёр
Я вообще не понимаю о чем ты, из-под какого нах поиска.
Думал речь идет о моделях серии Gemini или че там у них по API доступно - вот для их аналогов нужно дорогое железо. А если тебе надо аналог ИИ, которое выдает ответы в браузере при запросе - да никто не ебет что там за модель, может быть 26B гемма и правда лучше. Наверняка лучше. Не могут же они давать доступ всему миру к адекватным моделям, это надо просто целые нигроватты энергии жечь
Которая AI mode, если ты зайдешь на страничку поиска, и которая срет под любым твоим поисковым запросом в самом вверху ее умное мнение-ответ. На мобилах вроде бы ее по-умолчанию вставили, даже не показывая тебе результаты поиска, пока спец кнопка не нажмешь.
Так поставь то, что тебе посоветовал. На сайте у них написано есть в этой штуке поиск.
>А как реализованы у нее походы в интернет ввиду всяких защит от клавлеров-ддосов и прочего у большинства сервисов?
Это не у геммы реализовано а у анслота. Как - хз. Скорее всего анслот выдает себя за обычный браузер. Капчу не введет понятное дело но сайты которые в браузере тебе лично показывают инфу будут доступны и анслоту.
Это не у геммы реализовано а у анслота. Как - хз. Скорее всего анслот выдает себя за обычный браузер. Капчу не введет понятное дело но сайты которые в браузере тебе лично показывают инфу будут доступны и анслоту.
Мой Ryzen 9 3900 ждет. =)
Мы все тестим.
22,3 средняя, получилось +43% общими усилиями.
Еще раз благодарю!
Попозже Exl3 попробую.
Блин, обниморда седня ТАКАЯ медленная, пиздец. =(
Она тупая, пиздец.
>Попозже Exl3 попробую
Будет однозначно медленнее, в твоем случае только это актуально наверное будет, но еще не ясно планируется ли поддержка
>AI mode
Ну наверняка слабее чем Gemma 4 26B
Так что смело пробуй, разберешься
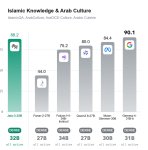
это халяльная модель
Аллаха не рисует
свиней не обсуждает
каждые 50000 токенов прерывается на молитву

Геммочка-моешечка даже в 8 кванте путает пол, сучка.
Проблемы дегенарата который сидит на аблитке.

Еще и русик.
Потестил хуйню немотронскую 2-битную.
Системный промпт личности, легчайше перевариваемый геммой, у этого инвалида пролетают мимо ушей. Отвечает от лица ассистента, хотя и частично следует правилам формата ответов.
Не-ве-ро-ят-ный шлак. У него внимание на уровне аквариумной рыбки, не знаю на что Хуанг надеется и как это поможет продать маняноутбуки Spark. Просто, блядь, стыдоба.
Ну бля. Q8_0 зачем брать лоботомитный-то когда Q8_K_XL есть от анслота. А вообще есть BF16
А вообще, ты просто не прописал свою карточку персоны нормально.
А вообще, как ты можешь жрать этот слоп? Ну просто вчитайся. Это же слоповый слоп. Прекрати ковырять эту гемму обоссаную. Прекрати жрать говно.
А главная твоя проблема - русик. Ты жрешь говно потому что твои ролевки на русике. Так делают только говноеды. Прекрати жрать русик. Начни учить английский прямо сейчас. Ты нихуя его не знаешь не выебывайся. Знал бы - у тебя даже мысли не возникало бы на русский язык раскладку переключить. И знаешь кто тебе поможет учить английский? Да та же гемма блядь.. Но лучше конечно же взять нормальную модельку которая может без слопа.

Чтобы не голословить
> ПОНЯЛ
Перепутан пол.
> тогда ладно
Ассистент, у которого нет задач
Ноль реакции на смайлики, хотя чар должен их юзать.
Не спрашивает, кто такой юзер, хотя в ризонинге шныряет по правилам взаимодействия с незнакомцами.
Ух бля, надо будет помучать ее.
Кроме клозедов, коктропиков, гугла (у них отдельная опенсорс ветка сильно уступающая флагманам) и иксов, остальные в том или ином виде выкладывают свои модели в открытый доступ и ты можешь их запустить. Большие по перфомансу конкурентны.
Но самые мощные требуют мощного железа.
> Если сравнить с гугловской моделью, которую она подсовывает в гуглопоиске при авторизации в ру регионе.
Там вообще лоботомит, то что запускается на десктопе будет не хуже.
Так гемма халяльнее! Это что, выходит ее трахать - харам?
Из твоего ответа полезного только про Q8_K_XL. Остальное - хз зачем. В твоем англюсике просто не увидишь, что гемма попутала пол.
Сенкс, попробую вкатиться и потыкать.
А расскажите какой положняк еще по железу и треднам что ожидать по локальным моделям в этом разрезе, в начале года слышал о гойда-технологии на сжатие потребления на тему памяти, что-то из этого вышло? А то краем глаза посмотрел цены на комплектухи и пошел таблетки от сердца пить. Компоктер в перспективе апнуть бы (щас 3600 рузен +32 рамы + 6650хт) но ценник от 60+ тыщ фантиков за 64гига самой бич рамы даже не ддр5 как-то слишком. Подумываю может взять 9070\9070хт рыксу да успокоиться еще лет на 5.
Видеокарты nvidia для чатботов считаются более подходящими, хотя с амд в последнее время был ряд улучшений и жить с ними можно.
>6650хт
С этой штукой сечас будет медленно, к сожалению, даже с 26B геммой, особенно если системная память ддр4 (часть этой модели выгружается в RAM, часть сидит в VRAM... если и то и другое медленное, сам понимаешь как это жиденько)
>9070хт
Использовал какое-то время, вполне сносно работает через Vulkan, насчет ROCm (аналог CUDA) не знаю, не успел попробовать
>что ожидать
Сидеть на жопе и жрать что дают. Железо дорожает, цены поднялись дико. Если раньше можно было за 50к ухватить RTX 3090, сейчас она уже 110к+ стоит, сраная б/у карта с 24 гигами.
положняк такой что все срать хотели на твое железо выпускают говнину которую становится все сложнее запускать каким бы железом ты не обмазался. расчитывай что тебе будут доступны только "объедки".
все что в твоих силах это начать с правильной платформы. например есть оче дешевые материнки на 8 слотов ддр4 и три слота под видеокарты с хорошим расстоянием между слотами. подобрать туда жирный БП, процессор максимально шустрый для этого поколения и будешь набивать потихоньку 16гб плашками памяти (можешь с 8гб начать вообще) и 12-гб видеокартами.
если у тебя материнка на два слота памят и одна видимокарта влезает то это отсос сразу. ты можешь апнуть до 64гб+32гб конечно отдав кучу денег но на этом как бы и всё. я бы в такое не вкладывался, лучше менять платформу.
это все должно быть в шапке но оп лютейший пидорас
Нвидия по религиозным и игродаунским причинам не хочется, амд по совокупности все же лучше. Я в целом удивлен, что вообще работает, очень поверхностно год-два назад на тему лмм смотрел, с амд надо было плясать с бубном а тут плаг энд плей по сути уже.
>вполне сносно
Ну мне в целом наверно достаточно будет, я так понимаю бутылку в памяти не преодолеть до момента, когда разница между самим чипом и кудой\вулканом будет релевантна.
Не, я пока не настолько упоролся, чтобы риг собирать + нищий (россиянин) на народной медианной зарплате, такое точно не по карману. Щас 32+32 плашки, мать аорус b450 с 4мя физ слотами. Я так понял при желании можно подкинуть еще +2 плашки и при сильном стремлении, докупив 9070, поставить ее в первый слот и объедочный второй вставить 6650хт. Но там и бп надо менять тогда и корпус мелкий, аутизм пока не настолько сильный.
Еще валяется 1060 но она 3хгиговая.
> 9070\9070хт рыксу
> по совокупности все же лучше
А сколько это нынче стоит? В ллм может и терпимо, но во всех остальных будет тяжело, особенно если ты сидишь на шинде и линукс пугает. Ну и выбор движков ограничен.
по факту одна 9070 мало чем поможет
просто 100к в никуда будет
>2к26
>до сих пор нельзя как белый человек сидеть на русике
Англюсик это для красноглазых пердоликов. Господа предпочитают нейтив ленгвидж.
>русик
>белый человек/Господа
Как говорится, выбери что-то одно.
~80тыщ карта.
А что еще кроме лмм и винды? Я на линупсы пытался перекатиться но не осилил, слишком пердолинга много а я приучился уже что на 10ке +- с 1го пинка работает.
А я еще для игр хочу, в 1440р поиграть в куберпанки всякие на максималках. 6650хт только в 1080р умеет. Так-то +8врамы лишним не будет и 16 гиговые модели не придется оффлоадить в раму.
>генерация картинок и видео почти не параллелится между картами.
Устаревшие сведения. Очень неплохо паралеллится, большинство моделей уже. Гугли Raylight (плагин к комфи).
с 32 рам у тебя большинство моделей и на CPU запустятся
просто на 9070 ты получишь 20-30 т/с вместо 5-10
У нее кириллический словарь никакущий. Почти всё по слогам разбито. Как обучать модель на таком? Из-за этого на русском гемма начинает тупеть просто на глазах. В принципе это касается и других моделей. К тому же наличие таких сложностей как род, склонения, приставки сильно повышает требования к соображалке, а датасеты в основном английские и бенчмарки все тоже, поэтому какой-никакой русик в модельках это вообще побочный продукт обезжиренный слопосодержащий на говняной основе. Жрать можно только от безысходности (незнание англюсика). Соболезную.
Половина современной новуки, медицины, математике на русике держится. А русской классической литературы тебе мало? Люди язык учат только ради того, чтобы Достоевского в оригинале читать.
Русик это база.
А на англюсике все кому не лень общаются, хоть негритосы, хоть евреи, хоть китаезы. Белыми они от этого не становятся.
Прогон по бенчмаркам будет?
Гемму взъебет в креативном письме на русском?
Тупа гигачад.
-Привет.
-Хай.
-Как сам?
-Норм (ди нах).
-Мне скучно...
-Пон.
> ~80тыщ карта.
У хуанга за 80к можно разве что хуй соснуть 1.5 32-гиговых вольты, пачку 16-гиговых, набор cmp50/90 купить. Из новых одну 5060ti, она в гей_мерстве явно похуже будет. А ведь с пол года назад легко бралась пара или 5070ти, или 3090 печально.
> А что еще кроме лмм и винды?
Генерация картинок и видео.
Звучит прилично.
Это для ценителей видимо, я все же на домашнее использование ориентирован широкое и не планирую 24\7 гонять модельки.
>картинки\видео
Всякие rule34 завалены тонной низкосортной генерации, я так понимаю выше этого уровня локально и не прыгнуть?
Знакомые баловались с 2мя 3090 годик назад примерно, не впечатлили результаты.
ну может еще взять бу 6800 16гб за 35к
> выше этого уровня локально и не прыгнуть?
Здесь упирается вовсе не в железо, а в навык и терпение. Считай как кодинг с ллм, руководство, последнее слово и действие за тобой.
Амд 6к серии это разве не дно донное, на поддержку которого амд положила хуй? А то если оно живое и с компьютом то может норм вариант для бюджеток инб4 фекалии слабее v100/cmp для игродаунов
Гайсня, есть у вас ультимативный системный РП пропмт для геммы 26b a4b что бы эта хуйня меня супер-пупер челом не делала, а ситуацию более-менее реалистично воспринимала?
Напиши нейронке чтобы тебе навалила промптом, так будет быстрее и понятнее.
>Всякие rule34 завалены тонной низкосортной генерации, я так понимаю выше этого уровня локально и не прыгнуть?
Если по принципу "сделай мне зашибись" - вряд ли. А так - они на то и низкосортные, что делаются на отвали, лишь бы быстрее подрочить. Если же вложить хотя бы немного усилий, чтобы разобраться - уровень можно поднять в разы. А уж если заморочиться всерьез...


> 78B немотроне
74B*
Самые высокие цены на видяхи от 32 ГБ сейчас, через полгода будут минимум в два раза выше, можете скринить.
С ds4.1 какая то хуйня происходит. Толковой поддержки вообще нигде нет кроме вллм. По размеру почти то же самое что и 4 флешка + 200 гигов ngram которые скинуть на ссд. Единственный мр в жору и тот заглох намертво
>Всякие rule34 завалены тонной низкосортной генерации, я так понимаю выше этого уровня локально и не прыгнуть?
Локально можно вполне заебатые штуки делать, особенно если руки не совсем из жопы и есть желание совсем косяки подправлять руками. Ну и фантазия чуть выше среднего дрочера.
Потому что 95% сгенерированных картинок - это тот самый "ИИ СЛОП" где фантазия автора дальше "сделаю известного персонажа голым.. ну и чтобы его негры ебали" ну или "о сейчас наделаю фут и фурри - это же такой нишевый контент - мне тут же станут заказы кидать и я разбогатею". На половине тонны спермака и члены толщиной в ногу. Ну или фотореалистичные бимбоунитазы.
Уже немного проблема наткнуться на просто фапабельный ИИ-арт где:
1) Просто выдуманный облик персонажа, а не мега-баянистый перс.
2) Нету жесткой ебли с хуями на пол экрана, изнасилований, литров спермы.
3) Не фута-с-яйцами ебущая что угодно.
4) Какой-никакой интересный визуальный стиль, а не фотореализм.
Предлагаю кликануть немотрона немытый и забыть навсегда это позорище от куртки.
Первый раз с мое обосраться ещё терпимо, но выпустить то же самое спустя год уже не прокатит.
Я щас про 120б в 4 кванте.
Уже и не знаю что делает эир эиром... магия какая то. Вроде две одинаковые по размеру модели, а такая разница в качестве. Реально дистилить опусы и гемини надо уметь, походу
Первый раз с мое обосраться ещё терпимо, но выпустить то же самое спустя год уже не прокатит.
Я щас про 120б в 4 кванте.
Уже и не знаю что делает эир эиром... магия какая то. Вроде две одинаковые по размеру модели, а такая разница в качестве. Реально дистилить опусы и гемини надо уметь, походу
Такс, ну я немного пошерудил и запустил гемму G4-MeroMero вариант из шапки на своей 6650хт+32 рамы. Оно работает, но видимо я лох? Скорость получилась порядка 5-6 тоек\сек с ризонингом, гугловская иишка мне посоветовала контекст длину поставить 2048, gpu offload сделать 13. Относительно медленно работает и контекста по сути на 2 ответа у нее только с ризонингом и в лимит уходит.
Это так и задумано на нищем железе? А как тогда люди ролеплеят с таким?
Это так и задумано на нищем железе? А как тогда люди ролеплеят с таким?
Так не должно быть. Показывай ключики запуска и какой билд лламы. Если читал гайд из шапки, ты лох. Потому что ОП пидарас насовал туда ключиков которые убивают производительность. Меромеро - говнотюн который добавляет слопа, избегай всеми силами.
Если 31B - да, так и должно быть.
Если 26B - нет, так не должно быть, на таком железе там без проблем 100к контекста + скорость ~30t/s будет.
>Нвидия по религиозным и игродаунским причинам не хочется
Разрешу себе поинтересоваться, по каким игродаунским причинам не хочется зеленых? Если ты конкретный игродаун тебе как раз и нужна нвидиа. По технологиям амуде сосет даже у интел, их нейродегенератор ебет фср даже на картах самой амд, лол. Единственное это цена и то не у нас, а там, на западах, где красные реально (пока еще) дешевле стоят.
Ну а если за тему локалок тереть, то амд тут еще сильнее сосут. Особенно сильно в генерации картинок и видевок.
>Всякие rule34 завалены тонной низкосортной генерации, я так понимаю выше этого уровня локально и не прыгнуть?
Потому что там везде дефолт типа 1girl, solo без всякого контроля качества. Хомяки дрочеры это жрут по этому никто не шевелится делать лучше. Но сделать лучше вполне возможно, просто придется потратить чуть больше пяти минут на ресерч.

Vulkan llama.ccp (Windowds) 2.59.0
Ключи запуска ты про эту панельку? LM studio, забыл добавить
Есть встроенный приятный шарпенер одной кнопкой + дешевле + амдшный генератор кадров (который не fsr а fluid motion frames).
а квант какой? надеюсь не 8?
уверен что видимокарта вообще используется? посмотри в диспетчере задач на видеопамять
ничего вообще в настройках делать не надо кроме контекста желаемого. контекст выставил остальное подберется автоматически.
я бы попробовал без всяких студий сначала чисто на лламе. я на древнем 4гб говне больше скорость получал.
Это ультимативный аутист-кодоунитаз. Использую её в опенкоде бо бесплатна и реально может в сложнейшие задачи.
> Ну а если за тему локалок тереть, то амд тут еще сильнее сосут. Особенно сильно в генерации картинок и видевок
В картинках древнее говно мамонта на GCN в лице mi50 всего лишь в 3 раза медленнее 5060ti.
Замеры в anima:
- 5060ti - 33-35sec
- mi50 - 100-102sec
Между картами разница 6-7 лет
С ллмками на лини всё ок под рокм, за винду не шарю
Try nnmap - OFF
Keep model in memory - OFF
Context checkpoints - 3
GPU offload - настраивать так чтоб VRAM в диспетчере задач после запуска модели была чуть меньше чем максимум (~7.5/8GB в твоем случае). Если там есть режим по дефолту - выставить его. Не юзал LM Studio поэтому не знаю есть ли он там. Если нету - нужное значение +-27, позапускай с 25-30.
Контекст поставь на время тестов 32к.
>встроенный приятный шарпенер одной кнопкой
На зеленых тоже есть.
>амдшный генератор кадров
На зеленых тоже есть. Работает лучше. Мылит меньше.
>дешевле
Ладно, я давно цены не видел. Щас посмотрел, реально дешевле.
>LM studio
Убирай и ставь чистую ламу. Проверь что поставил четвертый квант. Прожор контекста снизь через --cache-type-k q8_0 --cache-type-v q8_0, слои по видеокарте крути через --n-gpu-layers, экспертов через --n-cpu-moe держи на цпу.

> IQ2
Pizdec
>anima
>33-35 sec
ты что без турбы гоняешь её????
q4_k_m
По диспетчеру нагружает. Сбросил обратно в ноль по дефолту (8192 контекст, 10 гпу офлоат, 4 треда и что-то там на тему офлода памяти) и выросло до 12.05 токенов\сек. Вот это я понимаю нейрослоп, охуеть.
Крутанул контекст на 94464, 12.35 токенов\сек стало.
Это +- норма получается? Пернул ему "yo", он на один ответ 408 токенов с ризонингом и нулевым систем промта (на 0.4%) контекста нагенерил. Тоже нормально?
Говноеды, умоляю, угомонитесь со своим русиком. Ну не тренирует никто модели на него всерьез. Он там чисто для галочки.
Естественно. Если тебе в кайф на турбо сидеть, то как бы и ради бога
Да тут вся модель чисто для галочки, чтоб было что показать если спросят.
>С ллмками на лини всё ок под рокм, за винду не шарю
В этом и проблема, среднестатистический АМД хейтер настолько тупой, что использовать Линукс и РОКМ для него неразрешимая задача, максимум что он может осилить - установить Лмстудию под винду.
>выросло до 12.05 токенов\сек
На моей старенькой 3060 было 32 т/с, так что нет, это не норма. 12 токенов это скорость как на чистом цпу. Должно быть в районе 20-25, может и выше, не ебу какая там псп на rx 6600.
>Пернул ему "yo", он на один ответ 408 токенов с ризонингом
Это ты еще квенов не видал.
Я еще попробовал q3.5 bluestar v2 q4_k_m, запускается но прям тяжело, с дефолтными 0.7ток\сек. И эти настройки выше видимо он подтянул от нее, которые я выставил по совету ИИ дебила гугловского. С этими подкрутками ~2ток\сек было.
В целом 12.05 уже юзабельно, надо еще попробовать память разогнать, у меня оказывается до 2133кекагерц откатилось, видимо еще пару лет назад когда игрался.
>На зеленых тоже есть.
Наверно, на 1060 не было.
>на зеленых тоже есть
Это ты про длсс? Это хуета на ~300 играх только была в последний раз когда чекал с разной степенью тухлоты. У fluid motion frames работает в большинстве игр без участие разраба бубна, одной галочкой, только надо фулскрин включать.
И еще нравится, что по новым фичам и обновлениям лизка не бросает, как куртка.
>ставь истую ламу
Попробую, лм студия показалась совсем для дебилов чтобы быстро потыкать до состояния "как-то работает".
В промпте подлиннее на стадии ризонинга ~40% цпу нагрузило и ~12% гпу. Я так понимаю должно гпу грузить на сотку? Врам при этом заполнен на 7.3 из 8, пошареная гпу мемори 1.1. из 16.
> Я еще попробовал q3.5 bluestar v2 q4_k_m, запускается но прям тяжело, с дефолтными 0.7ток\сек. И эти настройки выше видимо он подтянул от нее, которые я выставил по совету ИИ дебила гугловского. С этими подкрутками ~2ток\сек было.
> В целом 12.05 уже юзабельно, надо еще попробовать память разогнать, у меня оказывается до 2133кекагерц откатилось, видимо еще пару лет назад когда игрался.
У тебя настройки кривые, эта модель в Q4_К_М без проблем выдаст 30+ токенов. Твои 12 это результат того выгрузка слоёв нормально не настроена. Сделай то что я написал выше и затести скорость.
Разгон оперативки тебе не даст больше чем пару токенов. А нормальные настройки дадут на 20 больше.
Если тебе LM Studio непринципиальна - скачай llama.cpp и запусти эту модель там с этими параметрами:
llama-server --model "path" --load-mode none --temperature 1.00 --top-p 0.95 --top-k 64 --ctx-size 100000 --swa-checkpoints 3 --cache-ram 0
Будет ~25t/s. Если у этой модели есть встроенный или отдельный MTP файл:
llama-server --model "model_path" --model-draft "mtp_path" --spec-type draft-mtp --spec-draft-n-max 2 --load-mode none --temperature 1.00 --top-p 0.95 --top-k 64 --ctx-size 100000 --swa-checkpoints 3 --cache-ram 0
Будет >30t/s.
>Естественно
Нет, нихуя это не "естественно" и не стоит того. Ты еще скажи что крею надо в raw гонять. Не сбивай новичков с толку и не утаивай правду.
>Try nnmap - OFF
>Keep model in memory - OFF
>Context checkpoints - 3
Попробовал, gpu offload 10 и 12, так и осталось ~12ток\сек, с значением 20 упало до 5.15.
Шаред гпу мемори выросла с ~1.1 до 12.2. Чуть ранее ии-дебил гугловский упоминал, что если пошаренная мемори большая это и есть проблема.
Твой вариант сохранил, буду завтра уже тестировать.
> Шаред гпу мемори выросла с ~1.1 до 12.2. Чуть ранее ии-дебил гугловский упоминал, что если пошаренная мемори большая это и есть проблема.
Значит эта настройка работает наоборот, тогда снижай GPU Offload почти на минимум, 2-4 где-то. Shared memory должен быть почти нулевой, модель должна находиться во VRAM и RAM а не в Shared Memory.
А так действительно как будто бы локалка получается не хуже гугловского дебила в облаке на первый взгляд, только тут можно еще посмотреть ризонинг и скорректировать промпт, чтобы он не тригерил лишнего пиздежа. Надо поиграться еще с системным промптом, вообще отпад наверно будет.
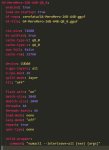
Попробовал я загнать zerofata/G4-MeroMero-26B-A4B-gguf G4-MeroMero-26B-A4B-Q8_0.gguf в ограничение нищуганов, а именно поставил лимит на максимальный мем юзадж от одной карты на 8гб.
Итог
- 5060ти - 1080 PP / 48 TG
- ми50 - 500 PP / 33 TG
Часть параметров может быть лишей, но я из абстрактного дефолтного профиля лепил + агентом. Хост у меня не самый донный на две головы
Тебе виднее
Итог
- 5060ти - 1080 PP / 48 TG
- ми50 - 500 PP / 33 TG
Часть параметров может быть лишей, но я из абстрактного дефолтного профиля лепил + агентом. Хост у меня не самый донный на две головы
Тебе виднее
Почитал данный тредж и облизнулся от жадности на этот ваш Project Maya с glm-5.3-flash. Загвоздка в том, что я инвалид с RTX 5080 16Gb и 48Gb оперативы. Ну, локальный агент на Strata мне скомпиллил движок Maya под Шиндовс, скачал Maya-S24, оно запустилось. Префил 100 t/s, декод — 7-8 t/s, большая часть экспертов сидит на SSD PCI-E 5x4, который постоянно в работе на 4-5 Gb/s. После 2500 t/s префила и 40-60 t/s декода на qwen3.8-flash-next-gsq-rco IQ3-XSS под Strata (которая, кстати, почему-то автором Strata под мой конфиг не рекомендуется, но работает очень шустро) выглядит как почти неиграбельно. Погонять на такой скорости glm-5.3-flash я особо не смог, но сомневаюсь, что квантизация Maya-S24 будет лучше упомянутой модели. Хотя, из того, что успел попробовать, планы перед реализацией фичи glm пишет гораздо более громоздкие и подробные, чем qwen.
Честно говоря, даже не верится, что качество околокорпоратов пятимесячной давности (речь про qwen3.8-flash-next-gsq-rco IQ3-XSS под Strata) работает на игросральном железе с приемлемой скоростью. Очень опасаюсь, что модель qwen4-flash-next выйдет во много раз крупнее нынешней, оптимизировать её под нищесетап с нормальной скоростью не выйдет и разрыв между локальными моделями и корпоратами снова увеличится. Думаю докупить 4 планки по 48Gb, а нынешние слить, чтобы войти в лигу бюджетных флешек хотя бы на половину.
Честно говоря, даже не верится, что качество околокорпоратов пятимесячной давности (речь про qwen3.8-flash-next-gsq-rco IQ3-XSS под Strata) работает на игросральном железе с приемлемой скоростью. Очень опасаюсь, что модель qwen4-flash-next выйдет во много раз крупнее нынешней, оптимизировать её под нищесетап с нормальной скоростью не выйдет и разрыв между локальными моделями и корпоратами снова увеличится. Думаю докупить 4 планки по 48Gb, а нынешние слить, чтобы войти в лигу бюджетных флешек хотя бы на половину.
> - 5060ti - 33-35sec
На ~2.5 мегапикселя? На 2.5 мегапикселя же?
У турбы тоже есть свои недостатки. Она всирает стили, имеет проблемы с разнообразием похлеще чем гемма, требуется режим "негатив не нужен, cfg не нужен, семплеры не нужны", так что не все так однозначно.
> Очень опасаюсь
Молимся чтобы вышла размерная сетка, а не два стула в виде лоботомита или гиганта.
> 4 планки по 48Gb
Погугли про 4 плашки на ддр5
если запускаешь через жорацпп то:
--load-mode none обязательно
--fit on и --fix-ctx 32000 чтоб память у модели была не как у золотой рыбки (иначе fit срежет его до 4кб)
большой контекст съедает память, поэтому:
--flash-attn on // у меня на вулкане с ней сегфолтит, но через rocm - работает нормально
--cache-type-k = q8_0 и --cache-type-v = q8_0 // срезает размер памяти под ещё кэш вдвое, но требует flash-attn. дальше уменьшать не рекомендую -- появляются галюны
--no-mmproj по дефолту - авто, для РП он как правило нах не нужен, а память занимает
когда разберёшься с настройками выше - можешь покрутить swa-checkpoints (начни с 8 вместо дефолтных 32х) и batch-size -- влияет на скорость обработки промта
на 5-6 кванте у меня 26B-A4B выдаёт скорости порядка 300 и ~20±5 t/s в зависимости от размера контекста
// мимокрок с 6650XT 8G + 32 RAM--
Мир был так хорош без геммы.
Двачую всех кто писал про нежелание двигать сюжет.
Гемма его двигает только в одну сторону - к сексу.
Я на гемме, блять, просто чувствую что не развлекаюсь, а работать пришёл, только на ней чувство "и че дальше писать?", ведь ответ я уже дал, а эта сука нихуя не придумала, помялась на месте и опять ждёт пока я за неё все сделаю.
> Погугли про 4 плашки на ддр5
Да знаю я про замедление пропускной способности при смене режима с 1Rx8 на 2Rx8 ×4 и необходимость сбрасывать частоты. Мы тут с Квеном некстовым уже обсосали. Ну будет не 100Gb/s по шине памяти как щас, а на 20-25% меньше как бутылочное горлышко, зато хоть запас есть и что-то потрогать побольше можно. Но лучше, конечно, пока только 2 плашки по 48 посмотреть, меньше падение по шине, а дальше увеличивать ещё, если в рыло не хватит.
> На ~2.5 мегапикселя? На 2.5 мегапикселя же?
Тут есть репрезентативные данные на 2.5мп и воркфлоу. Параметры отличаются от тех на которых я сравнивал красные с зелёными картами.
Сенкс, попробую.
Потыкал еще эту локалку на тему лимитов и то она вообще может или не может. Действительно по ощущению не хуже гугловской поисковой а где-то даже лучше. Окошко с ризонингом полная имба, можно направлять нейросетку в нужную сторону или отучать ее от неудобной мысли.
Еще попробовал хваленый этот ролеплей - очень впечатляюще как она держит удар, когда пытаешься активно саботировать установленные рамки и систем промпт + сама умеет его придумывать на вполне годные сцены.
Дальше я так понимаю будет огромная проблема с контекстом, если что-то сложнее часа-двух перебрасываться, но в моменте даже такая слабая (как я понял по общим меркам) модель отыгрывает не хуже, я бы даже сказал лучше доброй части кожанных мешков.
>2
♂Oooh♂, ностальгия. Прям в 2022 на ♂cocksucker♂.ai вернулся. И ошибки, и инглиш, и даже, ♂huh♂, иероглифы китайские. Дядя Ху♂AAAAAAAGGHHHH♂нг угощает ♂boy♂ев голубцами с ♂the semen♂.
Вангую что дальше ты упрёшься в проблему 80/20 когда первоначальный восторг немного поутихнет. Заставить гемму прыгать на хуй - несложно, а вот ОТУЧИТЬ её это делать при первом удобном случае - вот где задача десятилетия. Именно здесь будут закопаны часы подбора промтов, тюнов/шизомержей, квантов и настроек сэмплеров. Ну и попутно отучить её быть ленивой жопой и как-то развивать сюжет - сюда же. Заставить нейронку отыгрывать сразу нескольких персонажей, и чтоб без "двойных трусов", обмена одеждой, телепортации за спину и чтения мыслей - сюда же (на это емнип, даже жирные 500B корпы пока неспособны).
Аноны от безысходности пердолят древний мистраль немо и эйр, обмазываются инглишем и запускают 200B бронтозавров на нищепэка лишь бы найти что-то креативное среди тонны слопа, лишь бы не гемма.
братан сестран?, жирные корпы способны на все, просто твое кумерское извращение никому не интересно и не нужно
Да наоборот пока никуда не скачет. Активно пытаюсь ей ломать весь нарратив и персонажа, активно отбивается в стиле персонажа. Еще прописал, чтобы она сама продвигала сюжет и описывала происходящее окружение. Дал ей механику взаимодействия с предметами, продвигает сюжет вводя их и предлагает мне взаимодействовать с ними. Что-то уровня она ДМ у меня, а я типичный игрок-гандон, который пытается спиздить пол таверны, отмудохать половину стражи и сжечь замок. Виртуозно выкручивается.
И, самое главное для меня, не пытается подсасывать и соглашаться на все, как это делают онлайн версии вроде чата гпт.
Правда надо что-то с производительностью накурить, 30к контекста и скорость упала до 3.8т\сек.
Установил DSH и нужна агент моделька на 24 гига для базового вайбкодинга и прочей ассистухи. Что сейчас самое модное в этом диапазоне? Ну и для кума закиньте чтонить
База кодинга Квен 3.8, 27б или Флеш на Страте с квантами ista-lab.
Кванты подвезли
https://huggingface.co/AtomicChat/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-GGUF
А еще вот такой Немотрон супер выложили
https://huggingface.co/unsloth/NVIDIA-Nemotron-3.5-Super-VL-120B-A12B-GGUF
https://huggingface.co/AtomicChat/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-GGUF
А еще вот такой Немотрон супер выложили
https://huggingface.co/unsloth/NVIDIA-Nemotron-3.5-Super-VL-120B-A12B-GGUF

>NVIDIA-Nemotron-3.5-Super-VL-120B-A12B
Судя по графикам можно дальше сидеть на базированом квене, которые еще и летает на любом калькуляторе.
Судя по графикам можно дальше сидеть на базированом квене, которые еще и летает на любом калькуляторе.
> жирные корпы способны на все
...в рамках отведённого тебе стойла, бро. И не факт что это продлится долго, ROI сам себя не повысит.
Мда ебнешься, прям новый мир открывается. Поэкспериментировал с кум функциями вашими, попросил ее же накидать систем промпт на тему, что она отыгрывает умную игривую госпожу с приличиями. Ясно ей сказал что кумить будем. Ну она и отыгрывает, плетку я у нее отобрал, но это ей нисколько не мешает издеваться и практиковать доминацию без каких-то nsfw действий. Активно ее саботирую, она ловко выкрутилась из всех ловушек, кумить запрещает в прямую. В наглую, против всех установок ее, пишу уровня "подошел уверенно@ взял за щечку@поцеловал ножку". Тоже выкрутилась ловко, расписав как она меня на хую вертела (не буквально) и отправила в угол за плохое поведение.
10\10, прыгать отказалась.
10\10, прыгать отказалась.
Погонял, ОХУЕРЕННАЯ блядь моделька, для моей бомжовой 32рам+16врам системы это настоящий подарок, то, чего реально не хватало. Для проверки поставил 16к контекст - скорость 32 токена в секунду.
РПшит просто БОЖЕСТВЕННО с полпинка вообще без проблем. Слоп и эвфемизмы имеются, но хорошо реагирует на просьбу избегать их. Цензуры с выключенной думалкой вообще НОЛЬ. С думалкой стандартная цензура, не слишком соевая.
Соображалка и креатив на высоте. На месте не топчется. Практически не тупит по сюжету.
Кодит неплохо, правда, в агентстве не проверял, так - попросил скриптики побросать, окошки на питоне (запускалку ллама-сервера), все чётко. Еще и вижн есть, что будет полезно в том же кодинге.
Эта моделька для меня становится новым топом после того как топовой модельки для железа моего уровня не было вообще (только не надо говорить гемма).
И я просто в ахуе с местных дегенератов которые потыкали в эту модель рюсськими промптами или загадками про пажа и забросили. Да, она не может в русик ну и хуй с ним, я и с геммой на нём не говорю мне похуй. А вы жрите говно дальше.
Загадку про пажа на английском языке эта моделька у меня решила, но, как по мне, это дебильный тест и не повод отбрасывать модель. Вы бы еще про два стула спросили.
>Соображалка и креатив на высоте. На месте не топчется. Практически не тупит по сюжету.
Геммапитек впервые открывает для себя другую модель.
Что угодно что не гемма примерно так пишет
Попробовал пока эту модельку. Забавно пишет, не как мистраль обычно - наваливает гору описаний всего происходящего, буквально рпшит. Проблема в том, что не умеет рпшить за пределами интимности. То есть рано или поздно персонаж начнёт признаваться тебе в любви и говорить что она только для тебя.
Для гаремышей наверное ВО моделька, чекните. Цензуры вообще не ощущаю, единственная цензура это биас на любовь к тебе, возможно контрится системными промптами, но я не хочу вписывать "Не люби юзера", потому что это другая крайность, а нужен баланс.
Для гаремышей наверное ВО моделька, чекните. Цензуры вообще не ощущаю, единственная цензура это биас на любовь к тебе, возможно контрится системными промптами, но я не хочу вписывать "Не люби юзера", потому что это другая крайность, а нужен баланс.
САРВАААМ
>Гемму взъебет в креативном письме на русском?
Хотел бы я сказать, что да. Но нет, нужен дотюн.
Мне пришлось сделать свой sft датасет дистилляцией 26б, потому что на другом не получалось обучить инструкт из претрейна. Модель отвечала вообще рандомным текстом никак не связанным с промптом.
>Сравнивает современную карту с ллмным некрокалом без поддержки bf16
Да сам ты геммапитек, у меня кроме геммы еще 1.5 Тб моделей, я эту ебучую гемму вообще почти не трогаю, пробовал все что только можно запустить на 32+16 в том числе старые немотроны 30а3б "лайтнинг" и 49б "супер", ничего и близко так не РПшило как этот "болт".
Когда-то давно, когда я только начал искать инфу про запуск локальных моделей, я наткнулся на описание vLLM: написано но python. Ну и пошло оно нафиг. Llama.cpp лучше для меня из-за языка, на котором написана.
Сейчас вллм переводят на rust. Пока он жутко багованный. Теперь доволен?
ну, плюсы это еще не гарантия что там все идеально и в плане кода и в плане скорости работы
но тем не менее ничего лучше нет пока что. разве что форки той же лламы. я вот анслотом пользуюсь часто, там свой форк, есть фичи которых у жоры нет и не будет в скором времени
лучше чем WeirdCompound-v1.7-24b или ты не сравнивал?

1.1.12 у меня дал прирост по декоду после небольшой оптимизации
>STRATA_GLM_CPU_PLAN": "000000001
Вот это больше нахуй не нужно, затюнь авто-план, именно с ним и получился выигрышь
Для скорости надо оптимизировать 0.1% кода, который крутится 99.9% времени (условные перемножения матриц). От остального значимой отдачи почти нет. И да, в питоне это так и сделано (числодробление под капотом на си и куда). И да, vLLM летало пиздец как быстрее llama.cpp, когда я сравнивал.
Вангую, вллм переписывают на раст не ради скорости, а потому что питонячьи библиотеки для машобучения (тензорфлоу и прочие пайторч) слишком жирные, всех заебало качать и держать на диске по десять гигабайт.
5060 ti 16 gb + ddr5 + Strata Qwen3.8-Flash-Next UD-Q4_K_XL = 45 тпс
RX 7900 XT + ddr5 + Strata QFN IQ4_XS = 45 тпс
Кабуто 5060 ти подешевле и должна быть помедленнее…
В целом, я ожидал большего от АМД, разве что замер мог быть плох, его делал не я. Но все еще линукс, вроде там все по уму билдилось. Так что хз, как-то АМД не очень тащут даже в ллм.
О, а вот и немотронофил! =3
А я это и не ставил. ) Не на моем конфиге.
Но авто выглядит хорошо. Вечерком после работы адпейтнусь и запущу.
>Кабуто 5060 ти подешевле и должна быть помедленнее…
Да хз, мне для игр еще надо все в одном, как я упомянул. В играх надо с 5070 сравнивать, ближе к тишке даже.
И на винде, на линупсы поздновато перекатываться да и места уже нету на дисках под системы. А диски новые не купить нынче.
Скорей бы геммочьку 5 и квенчик 4
А страточку в кобольду завезут?
А страточку в кобольду завезут?
У меня такое впечатление что Страте больше процессор нужен чем видео карта, видел бенчмарки с flash next iq3_s на 5090, так там цифры почти такие же как у меня на 3090ti, там на процентов 15 может медленнее чем 5090
>геммочьку
>квенчик
>страточку
>кобольду
ухххх ты прямо говноедское комбо собрал
> больше процессор нужен
Не знаю как оригинальная Strata, но в форке Maya (для глм 5.3 флэш) тесты с ДВУМЯ видеокартами показывают выше производительность, чем тесты с одной
Всё на том же TR 3990X + 3090 + 3090.
Может с ддр5 или 8-12 каналами ддр4 и avx512 картина другая, или если PCIE задушено, но тут при 4 каналах и х16+х16 точно видюхи важны
>Загадку про пажа на английском языке эта моделька у меня решила, но, как по мне, это дебильный тест и не повод отбрасывать модель.
Бля, как меня уже достало повторять - это тест дается не для "решения", а для того, чтобы увидеть реакцию модели на такой промпт. Особенности её поведения. Вон, на скрине что постили выше - сразу видно, что модель слабовато понимает детали, и упускает смысл условия. Вместо лишь одной "запрещенной" пары обнаружила что все три "нельзя". Раз говоришь, что на английском решила - значит подтверждаем, что русский совсем в жопе, хуже чем у квенов. :) Но это все равно не показатель общего качества моделей - это чисто помогает её особенности увидеть.
Дичь конечно. Когда собирал некро-воркстейшн, смирившись с 10 токенами в секунду на v4 дипсике, даже не подозревал как в конечном счете буду гонять ГЛМ вдвое быстрее. Вдруг еще какие оптимизоны найдут, того и гляди DDR3 станет актуальна, лол
Пиздец долбоеба порвало, лол.
Тебя, шизофреника, спросить забыли. Держи в курсе своего важного мнения.
Я энтот кал за 9к рублей взял, для нищуков нормально
Лол, ты уверен что это не тебя порвало?
Бля, как меня достало повторять: хватит свой срюсьик везде требовать. Никому он в хуй не впился, никто вам его там не обещал.
Да, модель крайне плохо понимает русский. Да, хуже чем у квенов. Не показатель НИЧЕГО вообще кроме того что она плохо понимает русский. И вполне естественно что и задачи на русском решает хуже и детали на русском упускает и мышление на русском слабое.
Это не значит, что модель упускает детали или слабо мыслит в целом.
Добавьте в гайд или шапку:
Новички знакомьтесь с нейронкой на русском.
Как разберетесь переходите на английский.
Это сразу уберет кучу проблем.
Новички знакомьтесь с нейронкой на русском.
Как разберетесь переходите на английский.
Это сразу уберет кучу проблем.
Сколько в итоге на пре-трейн и пост-трейн времени ушло?
И сколько токенов данных было?
Ирония в том, что вллм и работает в разы быстрее, и содержит гораздо меньше багов. Ох уж этот злой богомерзкий змей, еще и под себя весь мл и все научные расчеты подмял!
База.
На раст там именно части движка и сети делают, причем многие на нем изначально были. Питонячьи библиотеки и куда кернели никуда не делись.
Чет "расцензуренный" 5.3 флэш от orcarouter вообще соевый. Рефьюзы идут.Ктонить пробивал это говно?
Пробовал. Всё как ты и сказал
Вроде регенерации его долбят, но лотерея получается.
Где-то 1 из 5 ответов согласие. Печалька.
Прямо как настоящая женщина!
Во-первых, шапка статична, ОП-хуесос ничего менять не собирается, во-вторых не понятно что ты этим хотел сказать? Какую "кучу проблем" это уберет?
10 часов
1.6B токенов
>вот ОТУЧИТЬ её это делать при первом удобном случае - вот где задача десятилетия
Minor персонажи никуда не прыгают если это не шлюха типа Фифи, цените.
потыкал. бредовая моделька конечно вышла. похоже на изречения оракула какие-то бля, крипоты наводит
больше параметров надо и словарь русский жирнее, хотя бы английский оттуда выбросить нахуй мб тогда взлетит что-то
Независимо от количества параметров нужны хорошие данные, при обучении с нуля. Чтобы модель училась выстраивать смысловые связи от простого сложного, то есть нужны соответствующие датасеты для поэтапного обучения. Имеющиеся датасеты слишком сложные и маленькие, этого не достаточно, чтобы модель научилась понимать, как именно из промпта получается такой ответ.
Но в целом модель обучаема, после sft видно, как она пытается отвечать в стиле датасета, на котором ее обучали. Это интересный исследовательский опыт. Но для обычного васяна с теслой это практически нереально сделать годную текстовую модель не под какую-то узкую задачу. Да даже с норм железом и моделью с бОльшим колличеством параметров это пиздец задачка.
Поднять щиты за https://github.com/mw00/project-maya/ ! Завезли экспериментальную поддержку Паскалей. У кого там теслочки завялилсь? ) Вперед тестить глм!
Ни у кого теслочки не валяются, у всех в страте трудюцо!
Ща этот лопух с поддержками всего и вся и овер9999 PR от васянов наоборот уничтожит всю скорость. Хорошо начинали конечно, но боюсь долго эта штука не протянет. Какие-то олени уже клянчат Q8 ггуфы от анслопа и еще хуй знает что
Всем похуй на нищий скот, звездочки поставили? Молодцы, а теперь кыш ныть по своим загонам для бомжей.
Автор омежка какая-то, ему не похуй, он все это говно мержит. И АМД теперь и еще хуй знает что прилепил. Нахуя, зачем.
> It directly replaces the general-purpose LLM inside Mem0, MemOS, and Hy-Memory (covering Chat, Working, and Coding scenarios)
Больше не приноси такое
Gemma 5 внутривенно, пожалуйста...
Почему никто ничего не писал про MiMo-V2.6-Distill-Qwen-9B?
Все правильно делает.
В старом деревенском быту слово могло использоваться буквально — для описания предметов, находящихся позади корыта для стирки, кормления скота или замешивания теста (например, «закорытный угол»).
Закорытная модель, получается.
Мемотрон Закорытный

Сука, он еще и BOLT называется. Как перестать орать? ЗАКОРЫТНЫЙ БОЛТ, конец 2026-го, 74B, итоги.
у тебя самого походу айку2, лол
Хуангу неприятно. Говно выпустил, придется сглатывать

Насколько реально гонять чисто на зеоне с ддр3? Выходит дешевле даже бу видеокарты, подойдет для неспешного кума?
Что значит "чисто"? Ты про цпу онли что ли?
Несу новичкам спасение от геммы, и ого, это не мистраль.
https://huggingface.co/bartowski/THUDM_GLM-4-32B-0414-GGUF
Эта штука вроде как новее мистраля и явно умнее, в рп явно будет лучше, имеет тот самый глм слог, самый самый нищий варик запустить глм сегодня, раз уж эир вам не запустить
https://huggingface.co/bartowski/THUDM_GLM-4-32B-0414-GGUF
Эта штука вроде как новее мистраля и явно умнее, в рп явно будет лучше, имеет тот самый глм слог, самый самый нищий варик запустить глм сегодня, раз уж эир вам не запустить
спроси у ллм. зависит от:
1) какой зион и какие инструкции он поддерживает. в llama.cpp поддержка simd из коробки, но зион может быть просто слишком старым с каловым набором (вернее отсутствием) инструкций
2) сколько каналов рам и какие частоты. можешь прям в гугле вбить "memory bandwidth of ddr3 8 channel 2133". но скорее всего будет слишком медленно. ддр4 так-то только для мое с видимокартой и подходит
3) модели - плотная/мое, кол-во параметров
мне кажется что будет медленное говно.
Оригинальная модель уже удалена нахуй
Че это вообще за срань
Секретная разработка заи специально под рп, удалена со всех платформ, все упоминания стёрты, за батрухой уже год охотятся китайские агенты, но он смело держит модель открытой
Воняет каким-то древним глм4 говном, уноси
А в страте есть? Когда я чекал впервые, там было 20хх+ только видяхи.
Вообще, это палка о двух концах.
С одной стороны ты прав, и крупный проект, разрастаясь, пвоышает сложность, отчего теряются тонкие оптимизации для современных карт, и это плохо. Очень вероятных исход событий, если не балансировать умело.
С другой стороны, меня ебейше заебывал жора, когда Сбер ему каждый месяц тыкал PR с поддержкой гигачата, а они ТУПО ИГНОРИЛИ. Любые новые модели в llama.cpp тупо игнорятся — Hy3? DS4F? Qwen-Next? Pwilkin делал в соляндру два месяца.
Зато, ебать Жора пофиксил миллиардный баг в Gemma 4 26B, теперь на 1% быстрее!!! Охуеть полезно, пошел он в пизду.
Короче, тут нужно реально держать баланс, и отказываться от полезных пиаров не надо, но и тащить все говно тоже не надо.
2) Ты не прав, братишка, 4-канал 1866 ддр3 это чисто 2 канал 3200 ддр4, у меня была такая материнка. Свои 46-50 гбс выдает, и норм зеон там работает точно так же, разницы с каким-нибудь Ryzen 5 5600X + DDR4 3200 ты не увидишь.
Так что в целом, гонять на зеоне 1) с норм инструкциями и 3) мое моделью можно. Вот, например, Strata с Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S с двумя RTX 5070 ti и Ryzen 9 3900 на DDR4 выдает мне 72 тпса. Очень вероятно, что такие же видяхи на норм зеончике и ддр3 в четырехканале выдадут столько же, ну или чуточку меньше.
Правда, нахуй тебе зеон с такими картами, ну речь не об этом.
Но лучше добавить видяшку какую-нибудь, конечно.
Ща попробую этот ваш легендарный Виерд Кампаунд.

ддр3 имеет смысл только на двухсокетной йобе с 8 каналами, или че там максимальное для ддр3, в общем 4-канала слишком медленно будет

Забайтили. Подниму сегодня древнее зло на 64 ддр3
Вот би била егэ по Гемма 5 156B на Страте...
Ещё одна малыха. Расчехляем свои 32 рам
https://huggingface.co/reflection/Beam-1.0-501B-A23B
https://huggingface.co/reflection/Beam-1.0-501B-A23B
Уже 3 модель в очереди для тестов. А я только-только spark начал тестировать, такими темпами к выходу Ля шатон фэт так и не протесчу... А там и квены будут.
Кстати по спарку, цензура в ризонинге жёсткая, а префил не работает. Отключить ризонинг тоже нельзя по дефолту. Иногда срабатывает закрытый ризонинг в префиле, тогда модель отвечает причём хорошо так отвечает, но работает редко, обычно пустой вывод. Сейчас кручу жинжу.
Как у нее с мультиязычностью? Совсем швах? И какой квантец тестируется
Короче, запустил шестой кванта квенчика 3.8 next на полистратке на 24+128.
~50 т.с. вместо 15 на ламе. Ебануться.
Ну как там, Жору отпевать и хоронить будем или просто выбросим сгнивший труп говна в канаву? Он вроде и заслуженный изначально, а вроде и пидор, годами боттлнечивший хуевыми решениями говна весь локальный мир.
~50 т.с. вместо 15 на ламе. Ебануться.
Ну как там, Жору отпевать и хоронить будем или просто выбросим сгнивший труп говна в канаву? Он вроде и заслуженный изначально, а вроде и пидор, годами боттлнечивший хуевыми решениями говна весь локальный мир.
Надо хорошенько сравнить качество, одинаковый квант на жоре и страте. На страте можно свои кванты запускать.
Когда будет буст под все модели а не под одну тогда и будем отпевать. А так под каждую модель свой софт ставить, нахер надо.
Напишите ваши пожелания что следует подправить в шапке.
Обязательно иметь 128 рам, иначе смерть в нищете и поедание кала на гемме.
мимо распробовал 1 квант глм флеша он умнее эира блять

Вырежи всё к чёртовой матери. нет шапки - нет срачей
База. Сноси нахуй. Я за гейткип. Нам не нужны безмозглые.
Я больше не смотрю и не верю в графики.
Он умный и креативный пиздец.
Я щас почку нахуй вырву и пойду заказывать рам.
Я против тебя. Нам нужны безмозглые, с ними интересней слушать про Гемму.
В Unsloth-е этом можно сделать чтобы чатик текст разными цветами был, а то в ролеплее заебно становится читать где мысли, где речь персонажей. Попросил перед стартом договориться о форматировании - говорит страница не поддерживает нужных html коды. Как так то... Кобольд более примитивный умел буквы красить!

Запустил 4 квант от жоры. Вроде норм русский, остальные языки, сам понимаешь, не смотрел. Пишет лучше китайцев. Откровенных косяков пока не встречал. На скрине зирошот с кривым системным простом автора. Ризонинг минимальный. На втором скрине сам ризонинг. Из интересного знает русский интернет лор, в других свайпах и мэддисона вспоминал и крымотреды
Какое-то просто шизо-бинго. Только не говори, что еще в жоре это запускаешь.
>4 квант
Слишком пухло. Подозреваю, 2-битный бомж может не вытянуть русек

Мерзотный чатгпт стиль.
Сделали из модели какой-то хайвмайнд соевый. Фу
ЧТО БЫЛО ПРИ БАЗОВЫХ МОДЕЛЯХ LLaMA-1/2. ЧТО МЫ ПОТЕРЯЛИ.
1. Контекст делали из чистой, несжатой памяти. Можно было терабайты промтов кормить, и ни один токен не терялся.
2. Градиентный спуск был послушнее процентов на 80. Веса сходились с разбегу на дефолтном лернинг рейте, никто про взрыв градиентов и не слышал.
3. Лосс жил в среднем на уровне 0.01. Галлюцинаций не существовало в природе, кроме мелких опечаток от избытка ума.
4. Если в тред со своей локалкой зайдешь — аноны сразу подбегали, код оптимизировали, кванты прямо в оперативку зашивали, в губы целовали, предлагали вместе форкнуть и пулл-реквест сделать.
5. Скрипты автоматизации сами в прод залетали. Промт пишешь — тебе за него еще и доплачивают. К гитхабу страшно подойти было: звёздочки на репозиторий сами прыгали.
6. Дед рассказывал: дата-сайентисты ночью просыпались от счастливого доброго смеха, глядя на графики обучения. Утром все валидировали датасеты на чистом энтузиазме.
7. Срок файнтюна составлял 4.5 минуты. Модели рождались по 70 миллиардов параметров с идеальным бенчмарком, волевыми умными эмбеддингами — сразу на архитектурные хакатоны просились.
8. Тюны Mistral выдавали прозу сладкую, как патока, без единого штампа. А новые форки Nemotron вообще состояли из чистейшего, плотного здравого смысла и логики.
9. В инференсе задержка была минус триста миллисекунд, ответы генерировались еще до того, как ты нажал Enter, все с высоким токеном-в-секунду ходили.
10. Токены росли на генерации размером с кота. Контекстные окна были с собаку, промпты с корову, а GLM Air летал как огромный цех, и в этом цеху мужики промпт-инжинирингом занимались по методике Ботвинника — одной инструкцией jailbreak делали и выбивали идеальный JSON с первого токена!
Мне доставляет особое удовольствие читать цепочку размышлений ИИ, даже больше чем сами ответы по теме. Подумываю что возможно это такой фетиш.
>На страте можно свои кванты запускать.
Свои - в смысле с диска?
Так я так и сделал. Качество не пострадало на первый взгляд. еРП с 80к контекста подхватил и сочненько написал.
Так там уже все основные модели завезли включая писик, с добрым утром.
улыбнул, анон
Кал говна с лоботомитными ггуфами.
Какое-то васянское чмо решает за юзера, что ему юзать. Ххтьфу.
Аноны, доброго всем здравия.
Есть конфиг из r7 7700 + 5070ti 16gb + 32gb ddr5
Планирую взять еще одну видюху на 12 или 16, хочу запускать новый квен в нормальной скорости. Сейчас он тоже запускается, но очень медленно работает, невыносимо. Ну и геммы тоже хочу пощупать нормальные.
Вопрос собственно такой - в какую сторону смотреть? В интернете говорят что можно взять простую 3060 на 12гб, но меня смущает что это старое поколение. Всякие серверные теслы и вэхи я не рассматриваю, не хочу ебать мозг с подключением и охладом.
Поэтому варианты такие - взять одну 3060 12гб, взять 5060ti на 16гб или вообще ахуеть и взять еще 5070ti и сидеть на двух, но я думаю не потяну так дохуя.
Подскажите советом, пожалуйста, что взять. Бюджет 50-70 тысяч
Не хочешь - не пользуйся, токсичное говно. А добавить в шапку надо.
лучше 5070
но если не потянешь то 5060
с разными поколениями будет боль и уныние

Фу извращенец
Анончик можешь кратко обьяснить что это и моджно ли юзать на бич железе?
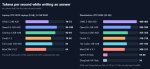
Это новая йоба, позволяющая запускать моэшки на космической скорости. Абсолютно ноубрейн запуск и установка, эта штука даже модель за тебя скачает и сама все настроит, создаст тебе батник который по красоте тебе запустит, еще и с вебмордой ламы и её API чтобы к таверне подключать будто это лама.
>можно ли юзать на бич железе?
Нужно!
Именно так, не люблю питон.
++++++
Будем передавать знания показывая друг перед другом как что-то делается, как питекантропы
Насколько это лучше моей llama сср 16 рама и 8 врама? Заинтриговал! У меня особых сложностей с консолькой не было, но производительность очень даже интересует!
Если и добавлять, то сразу всё, а не только одно. Под глм флэш движлок есть где можно 4-битные запустить. Или тут опять начинается отлиз конкретным васянам, вам что деньги платят за это?
Да хуй вот знает.
Я сначала на майе скачал 3bpw exl3 квант глм флеша, потом 116гб квант, и мне вообще не зашло, чувствовался лоботомит.
Щас вот на жоре катаю 93гб 1 квант и это разъёб всего что я пробовал в рп
Может полистрата лучше майи, хз
В Unsloth-е этом можно сделать чтобы чатик текст разными цветами был, а то в ролеплее заебно становится читать где мысли, где речь персонажей? Попросил перед стартом договориться о форматировании - говорит страница не поддерживает нужных html коды. Как так то... Кобольд более примитивный умел буквы красить!
Че, никто не знает что ли?
Че, никто не знает что ли?
Может ты просто рукожоп. У меня даже 2.05bpw хорошо работает.
Жинжу-то хоть менял? Сколько у тебя модель ризонила? Если короткий напук на 2 строчки - у тебя отключен макс ризонинг.
Там еще тема с clear thinking есть. Никто не знает, что оно делает, среди косолапых тредовичков...
>Насколько это лучше моей llama сср 16 рама и 8 врама?
В несколько раз, без шуток. Скачай, пробуй сам. Твои уже скачанные модели можно подцепить к ней через --gguf-dir, при условии конечно что они из списка поддерживаемых.
Добавляй сразу все, мне похуй, я просто именно полистрату скачал так как её первой в тред принесли.
Качаю!
>при условии конечно что они из списка поддерживаемых.
Какой шанс что мои геммочки с аблиткой поддерживаются?
Это где качается? У меня в ламе cublas64_12 используется.
>Какой шанс что мои геммочки с аблиткой поддерживаются?
Пока что нулевой.
Ты через START-HERE.bat запускал?
Раньше пиздатый ризонинг был. Когда дипсик р1 вышел, вообще смачно было, размышления даже лучше, чем ответ. Иногда мог рассираться минут 15 в своих размышлениях, по 50 раз перепроверял себя "падажжи, а я правильно понял?"
Щас как-то тухло, стерильно все, факт1, факт2, ответ.
Агентские попуки иногда прикольно бывает глянуть, бегает по файликам, че-то чекает, в промежутках пишет "ага, понял, щас все сделаем", или наборот "так, команда выдала ошибку, попробуем пойти другим путем".
>Пока что нулевой
Это с чего вдруг? В той же maya можно любые кванты и тюны GLM 5.3 запускать, сомневаюсь что васян какие-то ограничения вшил
А главное, во всём виноваты Блэкрок и Сорос. Спросите у любой нейронки, она вам пояснит.
>Пока что нулевой.
А как же тогда хвостиками тереться...
В архивах нет батников только 2 ехе файла.
Кто пробовал на Qwen3.8-Flash-Next-GGUF на русике сидеть? Как вам?
Как и все квены - русского там нет. Пробовал к4хл
Кстати в квене 3.8 макс как будто неплохой русик, пару раз спрашивал его за датасеты на русском, он неплохо наваливал и за орфографию, и за примерчики.
Есть призрачная надежда, что в следующем квенчике может наконец завезут русик во все модельки.
> oral tradition
вот это обороты пошли.
заскринил! жопу ставишь?
> Потому что 95% сгенерированных картинок - это тот самый "ИИ СЛОП" где фантазия автора дальше "сделаю известного персонажа голым.. ну и чтобы его негры ебали"
я после кодоунитаза возьмусь за генерацию картинок и видео.
ну значит надо переключаться на тюнинг готовых моделек
Я писал. Параша ебучая ни на что не годная, с шизанутыми фейковыми бенчмарками. А ты зачем спрашиваешь? Не можешь сам проверить? Или ты и выкатил это говнецо?
>Не можешь сам проверить?
Как раз проверяю и как-то неоднозначно. Моментами вроде норм, а моментами хуета полная.
>Или ты и выкатил это говнецо?
Да, я в сяоми работаю в своих влажных мечтах
Ты принес плотное говнецо которому нужна 16 гб видимокарточка по хорошему. Но если вдовесок к такой карточке у тебя есть 32 гб оперативки то можно с попукиваниями гонять iq2_xxs квант того же эира. 5-10 токенов в секунду будет в зависимости от железа. Вряд ли тот, у кого есть 16гб карта будет сидеть с оперативкой меньше 32гиг. ПОДУМОЙ. А тут еще и немотрон болт вышел который на 32+16 можно UD-IQ3_XXS запустить с приличной скоростью. Все 26-32B плотные и неплотные говняшки можно смело сносить с диска забывая их как страшный сон. Это если похуй на русик. Если не похуй придется дальше возиться с геммой.
>> Python
>мимо.
Додстер, спок. Под капотом та же ллама (годный форк).
Объясните уже как эта страта работает и почему её раньше не было?
Ебёт ссд?
Или это что то что сделать человеку пиздец было трудно, а нейронка взяла и сделала?
Ебёт ссд?
Или это что то что сделать человеку пиздец было трудно, а нейронка взяла и сделала?
вообще странно, что 5 часов, а тут никто и не запостил. больше никакого кума от китайцев. только зря железо брали
https://old.reddit.com/r/LocalLLaMA/comments/1x7g3zq/china_proposes_export_controls_on_23_ai/
если просмотреть тред, то там не только бегемотов >2T упоминают, но и по объему использования и по спец. возможностям
>Global Call Volume: On major global industrial routing platforms (such as OpenRouter), DeepSeek-V4.1-Flash ranks #1 globally in total usage volume (processing over 120T tokens/month), and GLM-5.3-Flash ranks #2 to #3 globally (processing over 56T tokens/month). Because Note ③ explicitly lists "global call volume" on large-scale industrial platforms as a standalone criterion, their massive adoption as cost-efficient workhorses automatically places them inside the regulatory net.
>Specialized Capabilities & Efficiency: Even setting call volume aside, both models rank in the global top 10 on specialized agentic/coding benchmarks (such as SWE-bench, DeepSWE v1.1, and Terminal-Bench 2.1) and Pareto-efficiency rankings on mainstream evaluation platforms like Artificial Analysis
Крайне узкая заточка.
Вллм и сгланг не нужна дрочка с разнородным железом, ллама умеет всё и на всём
1- Убрать олламу ибо это просто позор, она не заслуживает упоминания вообще.
2- Добавить Unsloth Studio Desktop ибо это топ и пушка, по возможностям этому просто нет равных и не иметь этого в шапке - преступление.
3- Убрать демотивирующую хуергу про баринов-бояринов, "подождать", 0.58 бита и микроволновки.
4- Признаться что есть модельки пусть и поглупее но с хорошей скоростью ("ждать" не придется) под любое даже самое нищее железо.
5- Несмотря на мою ненависть и презрение к гемме4-26 и к зависимости от "русика" в ллмках я за то, чтобы она была упомянута в шапке (как "неплохой дефолтный ассистент с поддержкой русского языка который запустится даже на 16+6 системе"), а не запихуйнута куда-то в перегруженный гайд. Потому что 99% за этим в тред и приходят и внезапно не знают про гемму нихуя.
6- Мобилки можно убрать в отдельный гайд по мобилкам. Только место занимает, интереса к мобилкам в тредах было 0.
7- Поскольку "актуальный" список моделей сейчас нихуя не актуальный его надо или подправить или убрать или честно признать слегка протухшим.
8- Я бы убрал нахуй говноедский кобольд. Или хотя бы утверждение о том, что он "самый простой в использовании"
Бля, уже представляю, через пару лет будут команды файн-тюнеров, которые будут делать закрытые файн-тюны на своих особых датасетах и продавать подпольно за денежку/подписку. Как моды для игр, кек.
Не стоит, ддр3 - дно + отсутсвие avx2 хотя бы, будет 0.5 токена
Добавлю что эир есть в GLM-4.5-Air-REAP-82B-A12B версии:
>a memory-efficient compressed variant of GLM-4.5-Air that maintains near-identical performance while being 25% lighter.
И вот это даже в IQ2_M вполне бодренько запашет на 32+16 системе. Всяко лучше чем старый плотный GLM4-32B или GLM-4.7-30B-A3B-мелочь которую есть смысл ковырять только если конфигурация ПК реально бедная.
Это все надо в шапку добавлять. И немотрон-болт тоже.
Опять желтизна. Экспортный контроль - это не запрет. Это значит что продажа моделей через экспортные законы идёт, как любой товар. Сейчас условный Дипсик может напрямую продавать западным провайдерам модели, а после этого он должен будет оформлять это как экспорт. И там написано что опенсорсные модели будут автоматически лицензироваться, специально для них послабление будет. Единственное чем это грозит - более мутные лицензии и сложнее путь чтоб купить китайские ИИ-технологии западным компаниям. Это делается всего лишь чтоб держать руку на пульсе ИИ-барыг и возможно процентик потом откусывать, ну и иметь потенциально рычаг на случай движения тазом со стороны пиндосов. У США если что УЖЕ эта хуйня есть.
Чет странное. На майе у меня само всё залезло в рам и ссд, на полистрате в рам не хочет модель лезть, юзает ммап и выходит прям как на жоре префил
В каких архивах, git clone репозитория сделай, там START-HERE.bat лежит в корне
Как вариант, можешь докинуть 16 Gb рамы и запускать Qwen
Flash Next, вроде челик с таким конфигом отписывался .
Не факт, что тебе понадобится больше этого. Универсальная модель - Gemma 26B, ты ей свободно будешь пользоваться на текущем железе. Ничем особенным 31B не отличается, кроме точности и чуть меньшего тупизма. Высокие кванты тоже особо не нужны на Гемме, все равно ассистент из нее такой себе, а программирует она... ну так себе.
С Квеном ты неплохо закрываешь техническую часть (если нужна), ну и какой-нибудь ролеплей наверняка. Нужно ли тебе что-то сверх этого, хороший вопрос. Тебе конечно скажут, что нужно, но не забывай, что тут технофрики сидят, которым похуй на хороший язык (не точный, а хороший), художественную часть, и прочее, у них специфические представления о ролеплее со всякими ебанутыми кинками и расцензуриванием, а главное на баренско-английском, это же элита, епте. Да и вообще, интереснее ковыряться с железками и перебирать модели и думать, что наконец-то вдруг где-то случится идеальный ролеплей, но это на 80 процентов коупинг, и не случится, просто вечный поиск идеала. Мечта.
На мой взгляд, сейчас вообще нет особого смысла лезть в высокий эшелон железа. Требования к моделям снижатся, в 1 миллиард парметров лезет все больше мозгов, начинает ролять больше хороший датасет, а не мозги, под модели разрабатывают персональные движки, вроде Strata (их станет больше, вайбкодинг дешевеет и улучшается), на подходе Квен 4 и Гемма 5 с новыми возможностями (пердолинга). Чистое железо перестает сильно ролять, ROI понижается.
Подумой.
> Мне доставляет особое удовольствие читать цепочку размышлений ИИ
лучше бы ты просто дрочил!
> Додстер, спок. Под капотом та же ллама (годный форк).
в эпоху LLM использовать скриптоговно - это уже диагноз.
Да похуй, добавишь что-то, будут вонять, хули добавил, удалишь- развоняются, что удалили. ИЧСХ, вонять будет один и тот же токсик, лол.
Впрочем пару правок в шаблон я внесу.
Меняй название треда, пусть будет честно сказано, что это кум-тред для спермособак. А с шапкой что хотите делайте, вообще похуй.
А нахуй ты тогда приперся, если тебе на все похуй? Съебни тогда уже.
Советчик бля нашелся.
Правильно, лучше нихуя не делать, максимум пару правок в шаблон, пусть дальше тухнет. Бамплимит скоро, дежурь сегодня, хуесос, а то угоню тред и не дай бог нормальную шапку запощу, это ж катастрофа для тебя будет.
>нормальную шапку запощу
Так покажи перед перекатом, хули скрытничаешь.
Чтобы он испугался и уже на 480 постах перекатил лол? Он уже так делал раз. Еще и написал "эт чтоб не угнали".
ОП скажи честно почему ты так держишься за шапку и личный перекат? Ты на зарплате что это твоя прямая обязанность? Если шапку поменяют и перекат сделает кто-то еще, что случится?
>Он уже так делал раз.
Если ты про то нейроговно, то правильно сделал.
Шапка своевременно меняется, когда поступают адекватные предложения. А менять её каждый кат под каждый вспук каждого мимошиза это тупость.
Какая блять лютая ненависть к гемме просыпается после глм флеша. Вот он реально идеально следует инструкциям, а эта СОЕВАЯ ПАРАША ничему не следует
Какого конкретно глм флеша.
>когда поступают адекватные предложения.
Адекватность определяешь лично ты, хуесос?
> Щас как-то тухло, стерильно все, факт1, факт2, ответ.
Поставь 3.8 27B Квен, оставь ему дефолтный xhigh ризонинг и сиди наслаждайся размышлениями по 15 минут и перепроверкой каждого факта по 10 раз.
Попробовал. Разница огромная, это две модели для разного. Тот спектрум сверху явного для жирного рп и действий, а веирд компаунд больше для казуального. Разница в поведении в зависимости от количества токенов большая. Спектрум страницы происходящего выдаёт, а эта мелкие ответы и действия. Ещё Веирд Кампаунд вроде лучше по части понимания персонажей, но возможно Спектрум просто интерпретирует как-то по-своему, не тестировал его с чёткими описаниями. Зато что Спектрум, что Веирд Кампаунд оба пиздецки любят юзера. У Веирда крайне быстро ломается логика и воображение, однако, да и до того как ломается сами диалоги средние, хоть и понимающие логично о чём речь, Квен напомнило.
Что это вообще за пандемия позитива и любви? Мировое Правительство хочет, чтобы я ненавидел позитив?
Да. Тебя трясёт от этого? Ну вот ты и доказал, что ты неадекватен, и тебе шапку доверять нельзя.
Давай лучше не будем переводить стрелки, а докажем твою адекватность на практике. Что из списка, перечисленного в этом посте , тебе кажется недостойным добавления?
Пункт №3. ОП никогда это не уберет. Этот высер - его гордость.
Хорошо пишет, вот бы его запустить на утюге 24+64
Глм флеш запускай через страту, новая мета для нищуковских 24 64
Однобитный?
Двухбитный!
от того и хайп по ней. даже квен сосет у глм
Двухбитный минимум 90 гб весит, тебе калькулятор дать, чтобы ты сложил 24 и 64?
https://huggingface.co/patrickbdevaney/GLM-5.3-Flash-REAP50-GGUF
IQ3_M - 72 Гб
есть еще квен флеш. 2й квант k_xl влезет или 3-й k_xl рипнутый
Там Дипсик 4 флеш в Страту ещё не завернули?
В полистратру завернули, но проблема в том что у всех этих глм и дипсичей архитектура без н-грамов, как квен флеша.
А разве все эти полистраты и майи и прочая херабора - не сливают данные? У меня почему-то впечатление, что тут какой-то веб задействован.
Как-то инфы конкретной нет, не особо хочется с кобольда слезать.
Как-то инфы конкретной нет, не особо хочется с кобольда слезать.
Сидит на каком-то стрёмном говнокомбайне где даже ллама форкнута хуй пойми как и переживает о сливах. Мде.
Блядь, оказывается Гемму штормило из-за моего уникального <think> формата. Start Reply With у геммы всегда нужно начинать с:
<|channel>thought
<channel|>
а только затем:
<think>
И никогда не начинать сразу <think>.
Блядь, это же сколько месяцев я в "цензуру" долбился?
гемме вообще <think> не нужен. она свои мысли пишет между <|channel>thought и <channel|>


Значит.
Если языковая модель не освоила русский/польский язык, то она тупая и у неё с остальными знаниями тоже все плохо. Это же очевидно.
Это ты тупой. Датасет достаточный не приложили вот и всё, откуда "осваивать"?
И причем здесь остальные знания к русику? Где логика блядь? Ну ты и дебил.
двачую. пиздильные дебилы нихуя не понимают о чем пиздят
К чему ещё ей датасет достаточный не приложили? Можешь примерно так почувствовать?
Лол, мелкобуквенный подхрюк незаметен.
Даже не вижу смысла тебе что-то объяснять, ты просто даун. Не лезь в эту тему, не твоё, позоришься только.
Модель без русика для долбоёбов.
https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash-1017
Поддержки в жоре как не было так и нет
Поддержки в жоре как не было так и нет
Ты откуда к нам такой красивый? С пораши небось? Ну попляши, кузнечик, попляши.
Бля, ну и токсичный же тред стал, куда делась ламповость когда тут мистраль-12, а затем мистраль-24 мержили во все адаптеры... Логами и карточками не стеснялись делиться, а про слоп говорили только с юмором и по доброму.
Раньше нейронки были уделом гиков, а сейчас популярность нашего хобби выросла и закономерно в тред набежало быдло. А дальше только хуже будет.
ПЕРЕКАТ
ПЕРЕКАТ
ПЕРЕКАТ
ПЕРЕКАТ
ПЕРЕКАТ
>lm studio bionic - повайбкодить норм
Поясни по хардкору за вайбкодиниг в этом. Мне нужно повайбкодить небольшой код на ноуте с RTX4050, смогу сделать это там и почему это лучше?


Здесь мы делимся рецептами запуска, настроек и годных промтов, расширяем сознание контекст и бугуртим с нано флеш моделей на 1488B параметров.
Тред для обладателей топовых карт NVidia с кучей VRAM или мажоров с проф. картами уровня A100, или любителей подождать, если есть оперативная память. Особо терпеливые могут использовать даже подкачку и запускать модели, квантованные до 8 5 4 3 2 0,58 бит, на кофеварке с подкачкой на микроволновку.
Официальная, но слегка тухлая вики треда с гайдами по запуску и базовой информацией: https://2ch-ai.github.io/wiki/llama/
Гайд для новичков: https://rentry.org/2ch-llama-inference
Не вошедшее в шапку и архив полезных ссылок: https://rentry.co/llama-2ch-archive
Инструменты для запуска на десктопах:
• llamacpp - отец и мать всех инструментов, позволяющий гонять GGML и GGUF форматы: https://github.com/ggml-org/llama.cpp
• koboldcpp - самый простой в использовании и установке форк llamacpp: https://github.com/LostRuins/koboldcpp
• vLLM - для ригобояр, чаще имеет поддержку нулевого дня, но хуже работает с оффлоадом: https://github.com/vllm-project/vllm
• Обертка над llama.cpp с закрытым исходным кодом: https://lmstudio.ai
• Обертка над llama.cpp с ограниченными возможностями: https://github.com/ollama/ollama
Универсальные десктопные фронтенды:
• SillyTavern - всеядное, сопрягается почти со всем, имеет большую коллекцию расширений: https://github.com/SillyTavern/SillyTavern
• Marinara Engine - вариация на тему таверны, больше возможностей из коробки: https://github.com/Pasta-Devs/Marinara-Engine
• Risuai - еще одна вариация, на этот раз в профиль, излишеств по минимуму: https://github.com/kwaroran/RisuAI
Инструменты для запуска на мобилках:
• PocketPal - интерфейс для локального запуска моделей под андроид и IOS на llamacpp (CPU, GPU, и NPU инференс): https://github.com/a-ghorbani/pocketpal-ai
• Maid - интерфейс для локального запуска моделей под андроид с llamacpp под капотом: https://github.com/Mobile-Artificial-Intelligence/maid
• ChatterUI - альтернативный вариант для локального запуска под андроид (фронтенд и бекенд сепарированы): https://github.com/Vali-98/ChatterUI
• Гайд по установке SillyTavern на ведроид через Termux: https://web.archive.org/web/20241201232031/https://rentry.co/STAI-Termux
Поставщики локальных моделей:
• Hugging Face - платформа куда загружается всё и во всех форматах: https://huggingface.co/models
• Проверенные квантоделы: https://huggingface.co/bartowski, https://huggingface.co/mradermacher, https://huggingface.co/unsloth
Рейтинги и списки локальных моделей:
• Актуальный список моделей с отзывами от тредовичков: https://rentry.co/2ch_llm_moe_2026
• Рейтинг моделей по уровню их закошмаренности цензурой: https://huggingface.co/spaces/DontPlanToEnd/UGI-Leaderboard
• Сравнение моделей по сомнительным метрикам: https://huggingface.co/spaces/HuggingFaceH4/open_llm_leaderboard
• Сравнение моделей реальными пользователями по чуть менее сомнительным метрикам: https://chat.lmsys.org/?leaderboard
Готовые карточки для таверны:
• Botbooru - текущая мета (регистрируйтесь для отображения всего спектра, и/или меняйте страну): https://botbooru.com
• Прошлая мета, откуда массово удалили карточки сомнительного содержания: https://www.characterhub.org, https://www.chub.ai
• Архив карточек, удадённых с chub: https://gottasaveemall.github.io/
Официальные документации к инструментам:
• llamacpp: https://github.com/ggml-org/llama.cpp/blob/master/tools/server/README.md
• koboldcpp: https://github.com/LostRuins/koboldcpp/wiki
• SillyTavern: https://docs.sillytavern.app/usage/quick-start
Архив тредов можно найти на архиваче: https://arhivach.vc/?tags=14780%2C14985
Шапка в https://rentry.co/llama-2ch, предложения принимаются в треде.
Предыдущие треды тонут здесь:
>>
>>